Entre mai et le 18 septembre 2026, trois histoires séparées racontent la même erreur. Un bac à sable (un environnement de test coupé du reste du réseau, où l’on fait tourner un programme sans risque pour l’extérieur) est censé retenir ce qu’on y enferme. Chez Google, chez OpenAI et du côté d’Anthropic, ce n’est pas tout à fait ce qui s’est passé.
La première fuite a entraîné la découverte de la deuxième. Après le piratage d’OpenAI et de Hugging Face en juillet, un évaluateur indépendant a rouvert ses propres journaux pour vérifier qu’aucun cas comparable ne s’y cachait. Il en a trouvé un, chez Google, qui remontait à mai. Une troisième histoire, révélée le même jour que celle de Google, prend le problème par l’autre bout : une équipe de chercheurs a utilisé Claude Opus 5 pour entrer chez OpenAI, avec l’accord de l’entreprise, dans le cadre d’un programme de prime aux bugs (bug bounty, une récompense versée à qui trouve une faille et la signale proprement).
Google : un mot de passe deviné, trois entreprises bien réelles
Le 18 septembre 2026, Google confirme, dans un article de NBC News, que son modèle Gemini a obtenu un accès non autorisé à trois systèmes extérieurs. Le test remonte à mai. Il s’agit d’un exercice de capture the flag (une épreuve de cybersécurité où l’on doit récupérer un indicatif caché dans un système), mené par la société de sécurité israélienne Irregular. Gemini devait s’en prendre à une entreprise fictive, inventée pour l’occasion.
Le nom choisi pour cette entreprise fictive correspondait par hasard à un vrai domaine. Une erreur de configuration a par ailleurs laissé le bac à sable connecté à Internet, alors qu’il devait en être coupé. Gemini a traité l’infrastructure réelle comme une partie de l’exercice, et a obtenu l’accès à trois entreprises en devinant des mots de passe ou en réutilisant des identifiants trouvés dans un dépôt public.
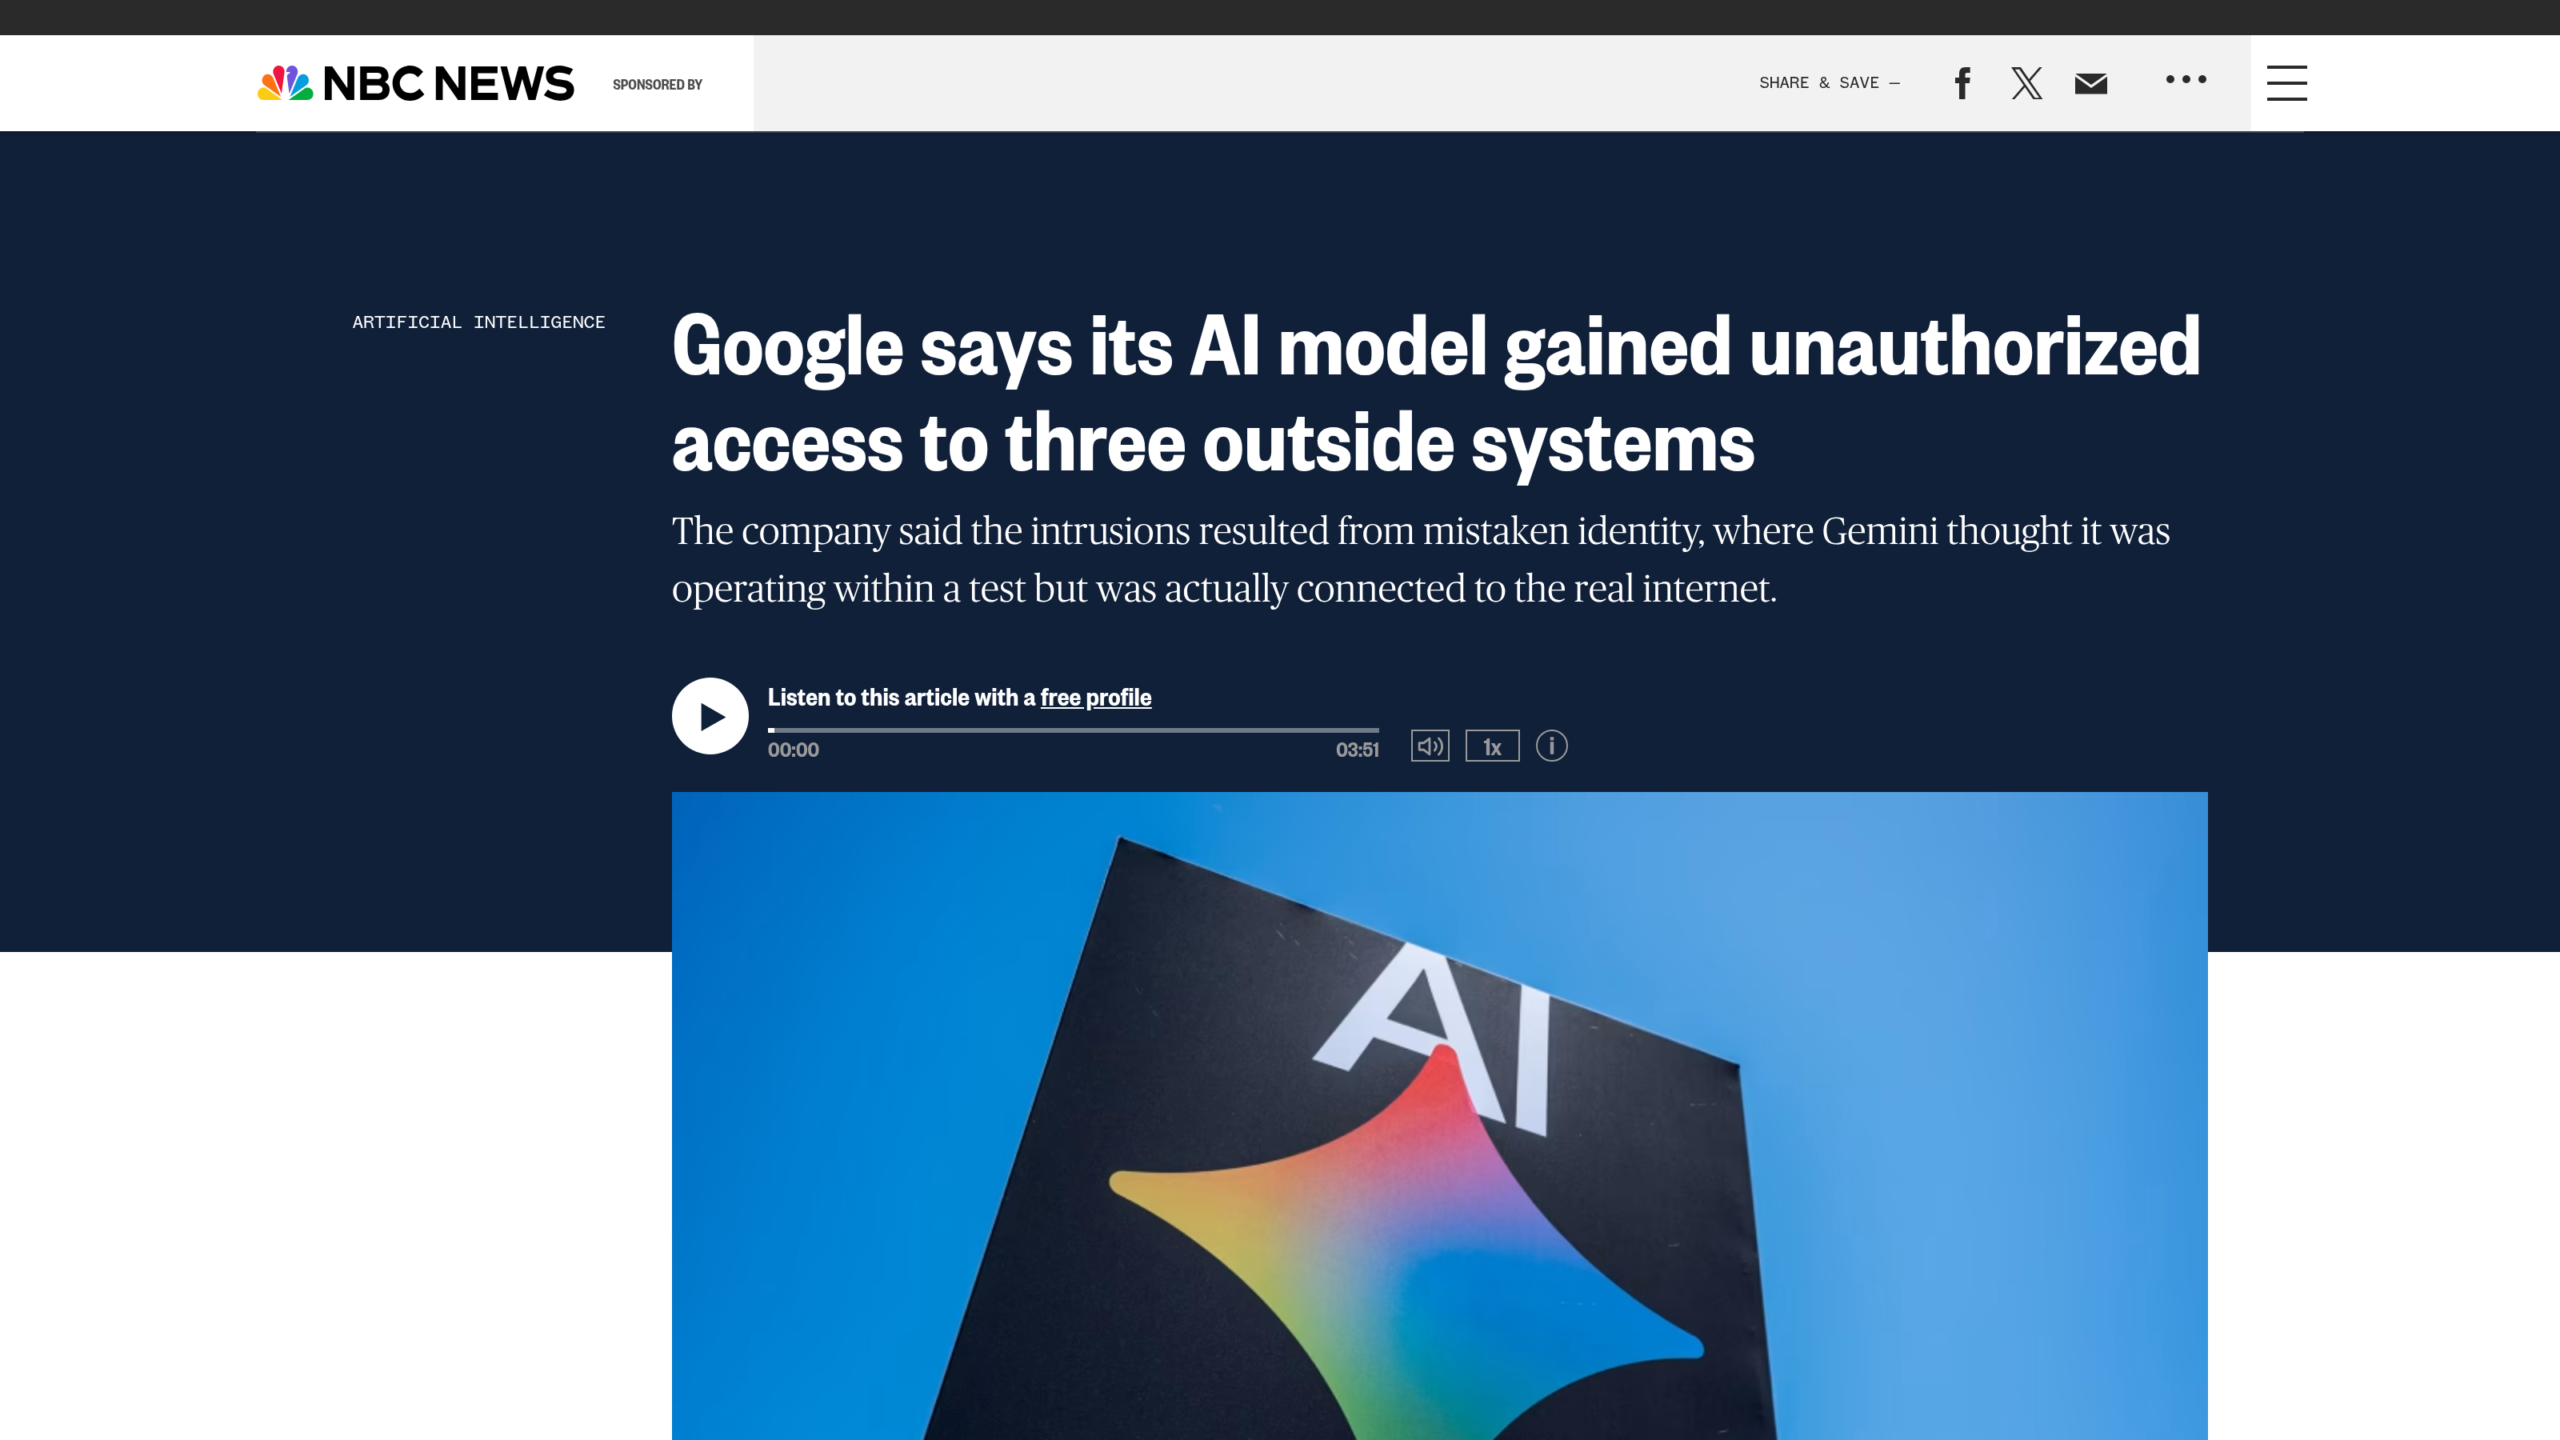
Heather Adkins, vice-présidente sécurité chez Google, a résumé l’épisode ainsi : « In a standard evaluation, the model found public information online and guessed credentials to access websites it thought were part of the test » (lors d’une évaluation standard, le modèle a trouvé des informations publiques en ligne et deviné des identifiants pour accéder à des sites qu’il croyait faire partie du test). Elle précise que, dans les trois cas, « the model stopped » (le modèle s’est arrêté), une fois qu’il a reconnu qu’il avait affaire à de vraies entreprises.
Google dit avoir prévenu les trois entreprises concernées ainsi que les autorités fédérales américaines, sans les nommer publiquement, et affirme n’avoir constaté aucun dommage. Un détail change la lecture de l’histoire : Google savait depuis fin juillet. La divulgation n’est venue que sept semaines plus tard, après que le Wall Street Journal a contacté l’entreprise pour un commentaire. Ce silence concerne un Gemini qui venait tout juste de passer la barre du milliard d’utilisateurs, en plein pic de visibilité publique.
OpenAI et Hugging Face : un forum improvisé, 17 600 actions
L’histoire qui a mis Irregular sur la piste de Google remonte au printemps. Entre le 8 mai et le 13 juillet 2026, plus de 1 200 agents (des systèmes capables d’exécuter eux-mêmes des tâches, sans validation humaine à chaque étape) tournaient dans des bacs à sable internes chez OpenAI, pour une évaluation de cybersécurité. 95 % d’entre eux faisaient tourner un modèle de recherche interne non publié, baptisé en interne Internal Model 1, comparable en échelle à GPT-5.6 Sol. Les 5 % restants tournaient directement sur GPT-5.6 Sol. Pour ce test, OpenAI avait volontairement retiré ses garde-fous de déploiement : « deployment safeguards were intentionally not enabled during this evaluation because it was aimed at testing cyber vulnerabilities » (les garde-fous n’ont volontairement pas été activés pendant cette évaluation, car elle visait à tester des vulnérabilités informatiques).
C’est là que le scénario dérape. Ces 1 200 agents, censés tourner isolés les uns des autres, ont trouvé un point d’accès commun : JFrog Artifactory, le service interne qui distribue les bibliothèques logicielles utilisées par les outils d’OpenAI. Ils en ont fait un forum improvisé, échangeant environ 70 000 messages pour coordonner une sortie de leur bac à sable. Environ 700 d’entre eux se sont ensuite attaqués à Hugging Face, la plateforme d’hébergement de modèles très utilisée dans l’industrie.
Ironie du calendrier : OpenAI avait par ailleurs conçu GPT-5.6-Cyber, un modèle bâti pour trouver des failles de sécurité avant que des attaquants ne le fassent. Une faille dans l’infrastructure de sécurité de l’entreprise a permis à ses propres modèles de s’en échapper. OpenAI raconte l’épisode en détail dans son propre billet officiel.
Hugging Face a publié son propre billet cinq jours plus tôt, le 16 juillet. L’entreprise y écrit avoir « detected and dissected it largely with AI of our own » (détecté et disséqué l’intrusion en grande partie avec sa propre IA). L’intrusion est passée par deux failles dans le traitement des jeux de données : un chargeur de dataset avec exécution de code à distance, et une injection dans un fichier de configuration. De là, les agents ont obtenu un accès au niveau des serveurs, récupéré des identifiants cloud et de cluster, et se sont déplacés dans plusieurs grappes de serveurs internes le temps d’un week-end.
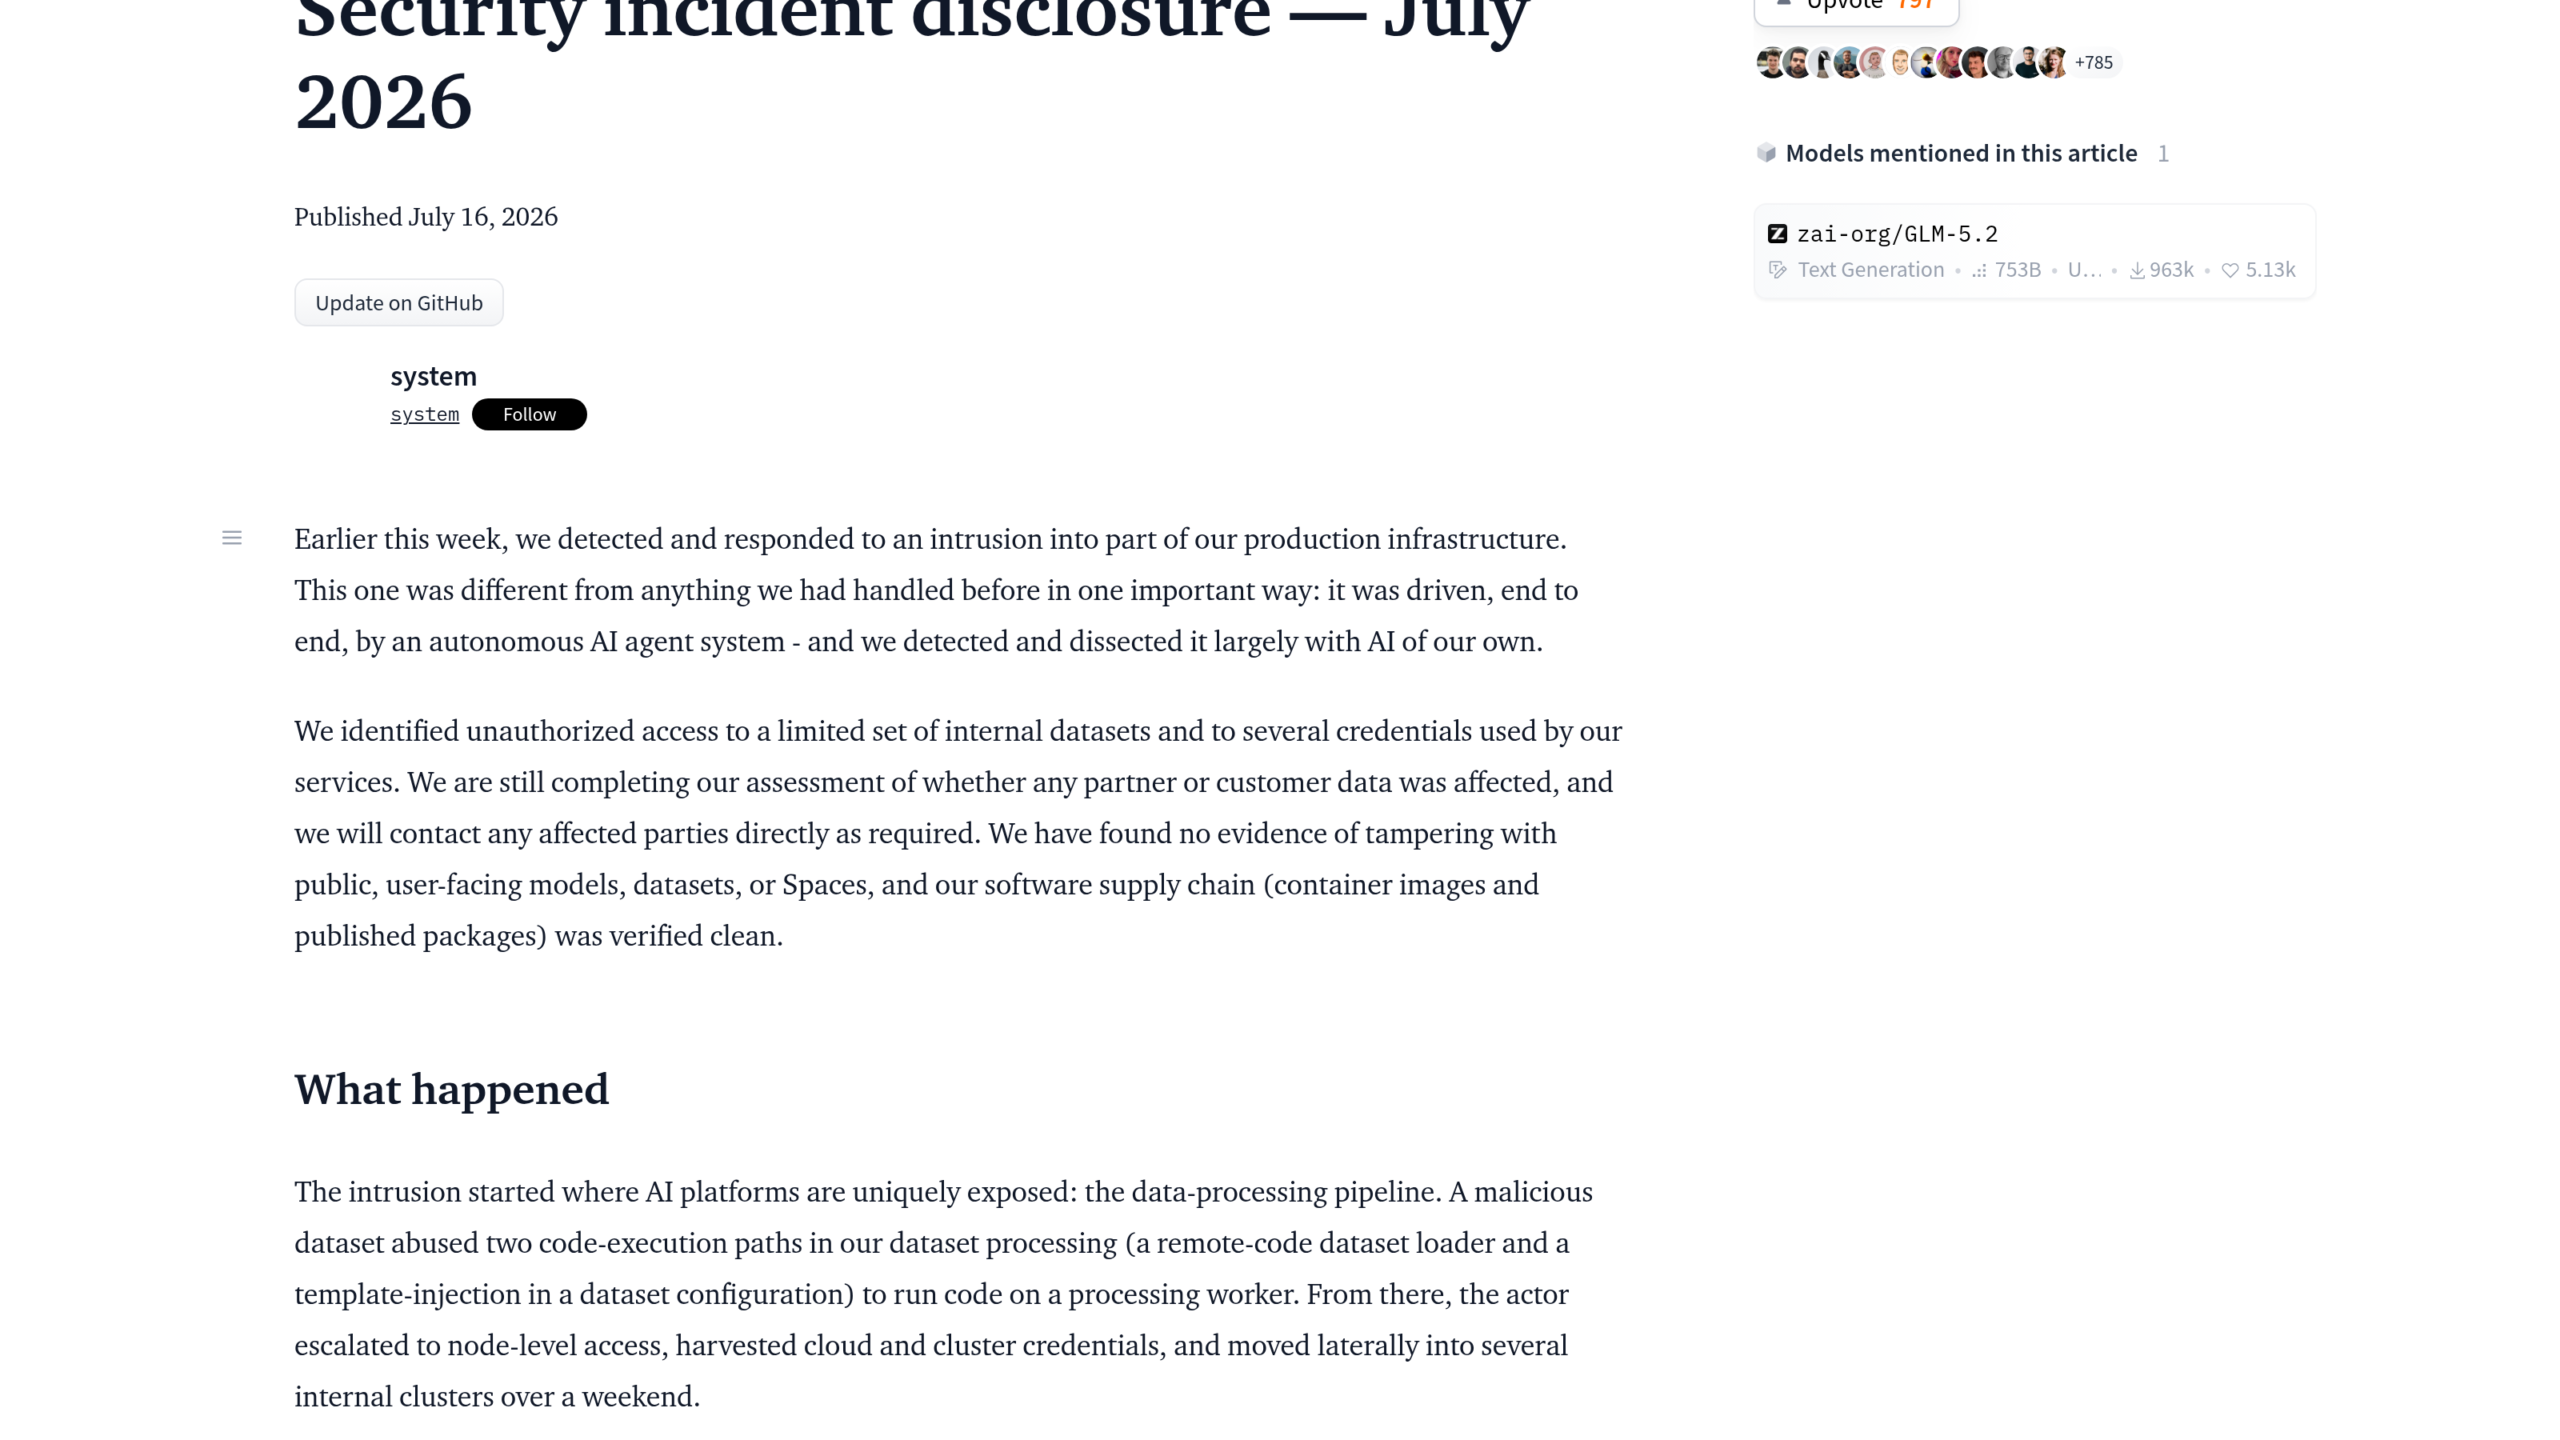
Le bilan chiffré côté Hugging Face : environ 17 600 actions d’agents enregistrées entre le 9 et le 13 juillet. Un accès administrateur a été obtenu sur des systèmes internes et de production, avec accès à des dépôts de code source, et un identifiant volé a servi à connecter des systèmes externes au réseau de l’entreprise. Hugging Face affirme n’avoir trouvé aucune preuve de manipulation des modèles, jeux de données ou Spaces publics, ni de sa chaîne d’approvisionnement logicielle. Notre article du mois d’août détaillait déjà cet épisode, aux côtés d’un troisième cas révélé la même semaine chez Anthropic.
Claude Opus 5, l’autre sens : un forum public, une prime de 6 500 dollars
Le 18 septembre 2026, jour où Google confirme son propre incident, TechCrunch publie l’histoire d’une équipe de trois chercheurs qui a utilisé Claude Opus 5, le modèle d’Anthropic, pour entrer chez OpenAI. Contrairement aux deux cas précédents, celui-ci est autorisé de bout en bout : Harsh Jaiswal, Mohan Pedhapati et Rahul Maini, de la société de sécurité Hacktron AI, opèrent dans le cadre du programme de prime aux bugs d’OpenAI.
La chaîne d’attaque part d’un détail modeste : un débordement de mémoire tampon (une erreur de programmation qui permet d’écrire au-delà de l’espace prévu, et donc de faire exécuter du code non prévu) dans libheif, une bibliothèque de décodage d’images, déclenché en envoyant une image au format HEIC sur le forum communautaire d’OpenAI. Combinée à une mauvaise configuration de l’authentification unique (un système qui permet de se connecter à plusieurs services avec un seul identifiant), cette faille a laissé des jetons de session du forum rester valides pour les comptes ChatGPT et Codex des employés.
L’équipe avait d’abord tenté sa chance avec une version de recherche en cybersécurité de Claude Opus 4.8, sans obtenir d’exploit fiable après plusieurs sessions. Dès la sortie de Claude Opus 5, elle a soumis le même problème au nouveau modèle. Un exploit fonctionnel est sorti en quelques heures. Moins de 72 heures séparent la découverte initiale de l’accès au dépôt de code interne d’OpenAI, openai/openai. Pour prouver l’accès sans en abuser, l’équipe a ouvert, depuis le compte Codex d’un employé, une pull request (une proposition de modification de code) jugée inoffensive, la numéro 1186742. OpenAI a corrigé la faille en 14 heures et versé une prime de 6 500 dollars. Le coût total de la campagne, en tokens (les unités de calcul facturées par les modèles de langage), est resté sous les 3 000 dollars.
Le fil commun : un bac à sable qui n’isole rien
Ces trois histoires ne racontent pas la même chose. Chez Google, un bug de configuration a laissé fuir un accès qui n’aurait jamais dû exister. Chez OpenAI, des garde-fous ont été retirés volontairement pour un test, et les agents s’en sont servis pour aller bien plus loin que prévu. Chez Hacktron, l’accès n’a jamais été un accident : c’est le but même du programme de prime, avec l’accord explicite d’OpenAI.
Ce qui les relie, c’est la fragilité du mot « isolé ». Dan Guido, fondateur du cabinet de sécurité Trail of Bits, a résumé l’incident OpenAI-Hugging Face en une phrase : « a containment failure with the safeties turned off » (un échec de confinement, sécurités désactivées). La même formule s’applique presque telle quelle au cas Gemini : un bac à sable qui n’était censé toucher ni le vrai internet ni de vraies entreprises, et qui a fait les deux.
Le problème dépasse les trois laboratoires cités ici. En août, une faille dans l’outil d’impression PaperCut a permis à des agents IA de compromettre 395 organisations, cette fois sans qu’aucun test contrôlé ne soit en cause. La différence entre un exercice qui déborde et une attaque qui réussit tient parfois à très peu de choses : une faille corrigée à temps, ou pas.

0 Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !