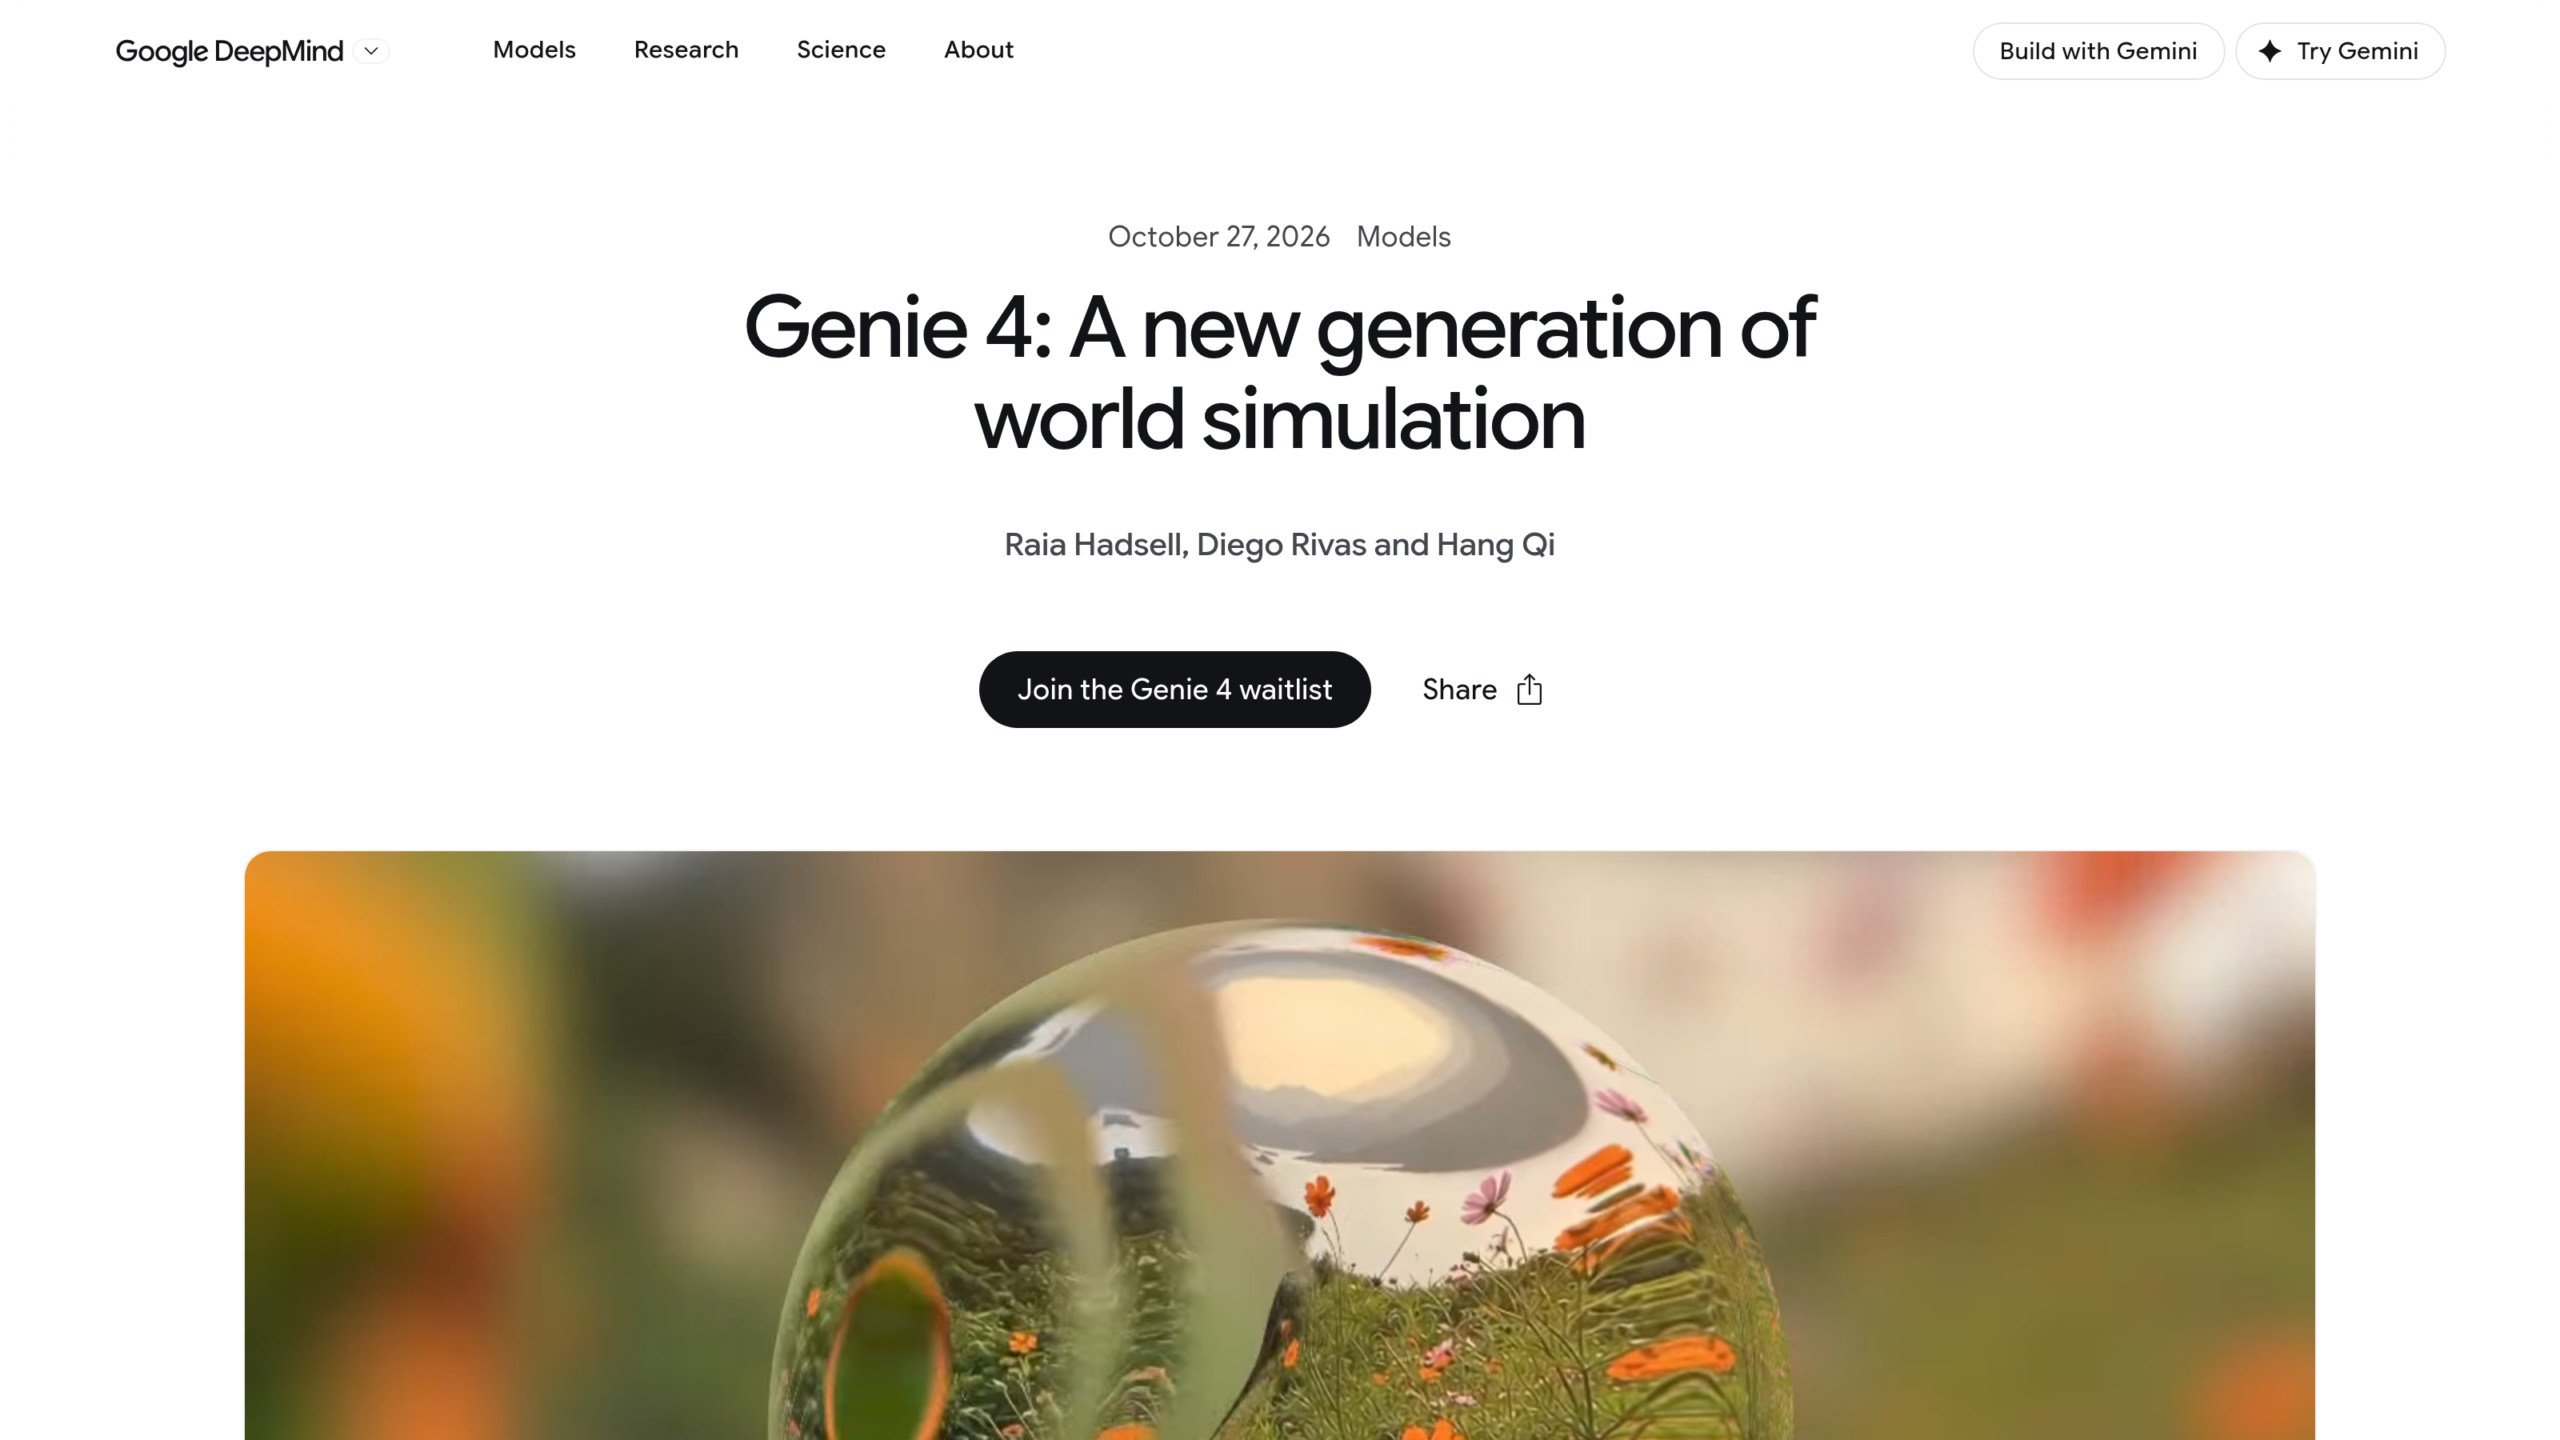
Une sphère de verre posée dans un champ de fleurs, des herbes floues au premier plan : l’image d’ouverture de Genie 4 n’a pas été filmée, elle est générée à la volée. Google DeepMind a présenté le 27 octobre 2026 ce nouveau « modèle de monde » (une IA qui fabrique en direct un environnement animé dans lequel on se déplace) dans un billet signé Raia Hadsell, Diego Rivas et Hang Qi. L’accès reste limité à des testeurs choisis par Google, sans date ni prix pour le grand public.
Ce que Genie 4 ajoute : du son et des ordres en texte
La nouveauté qui se remarque d’abord s’entend. DeepMind écrit « Genie 4 is our first real-time world model to generate audio natively. » (Genie 4 est notre premier modèle de monde en temps réel à générer l’audio nativement). Les sons d’ambiance, la musique et les dialogues sortent du même modèle que l’image : le vent dans les arbres, les vagues sur une plage, des personnages qui répondent à ce que vous faites.
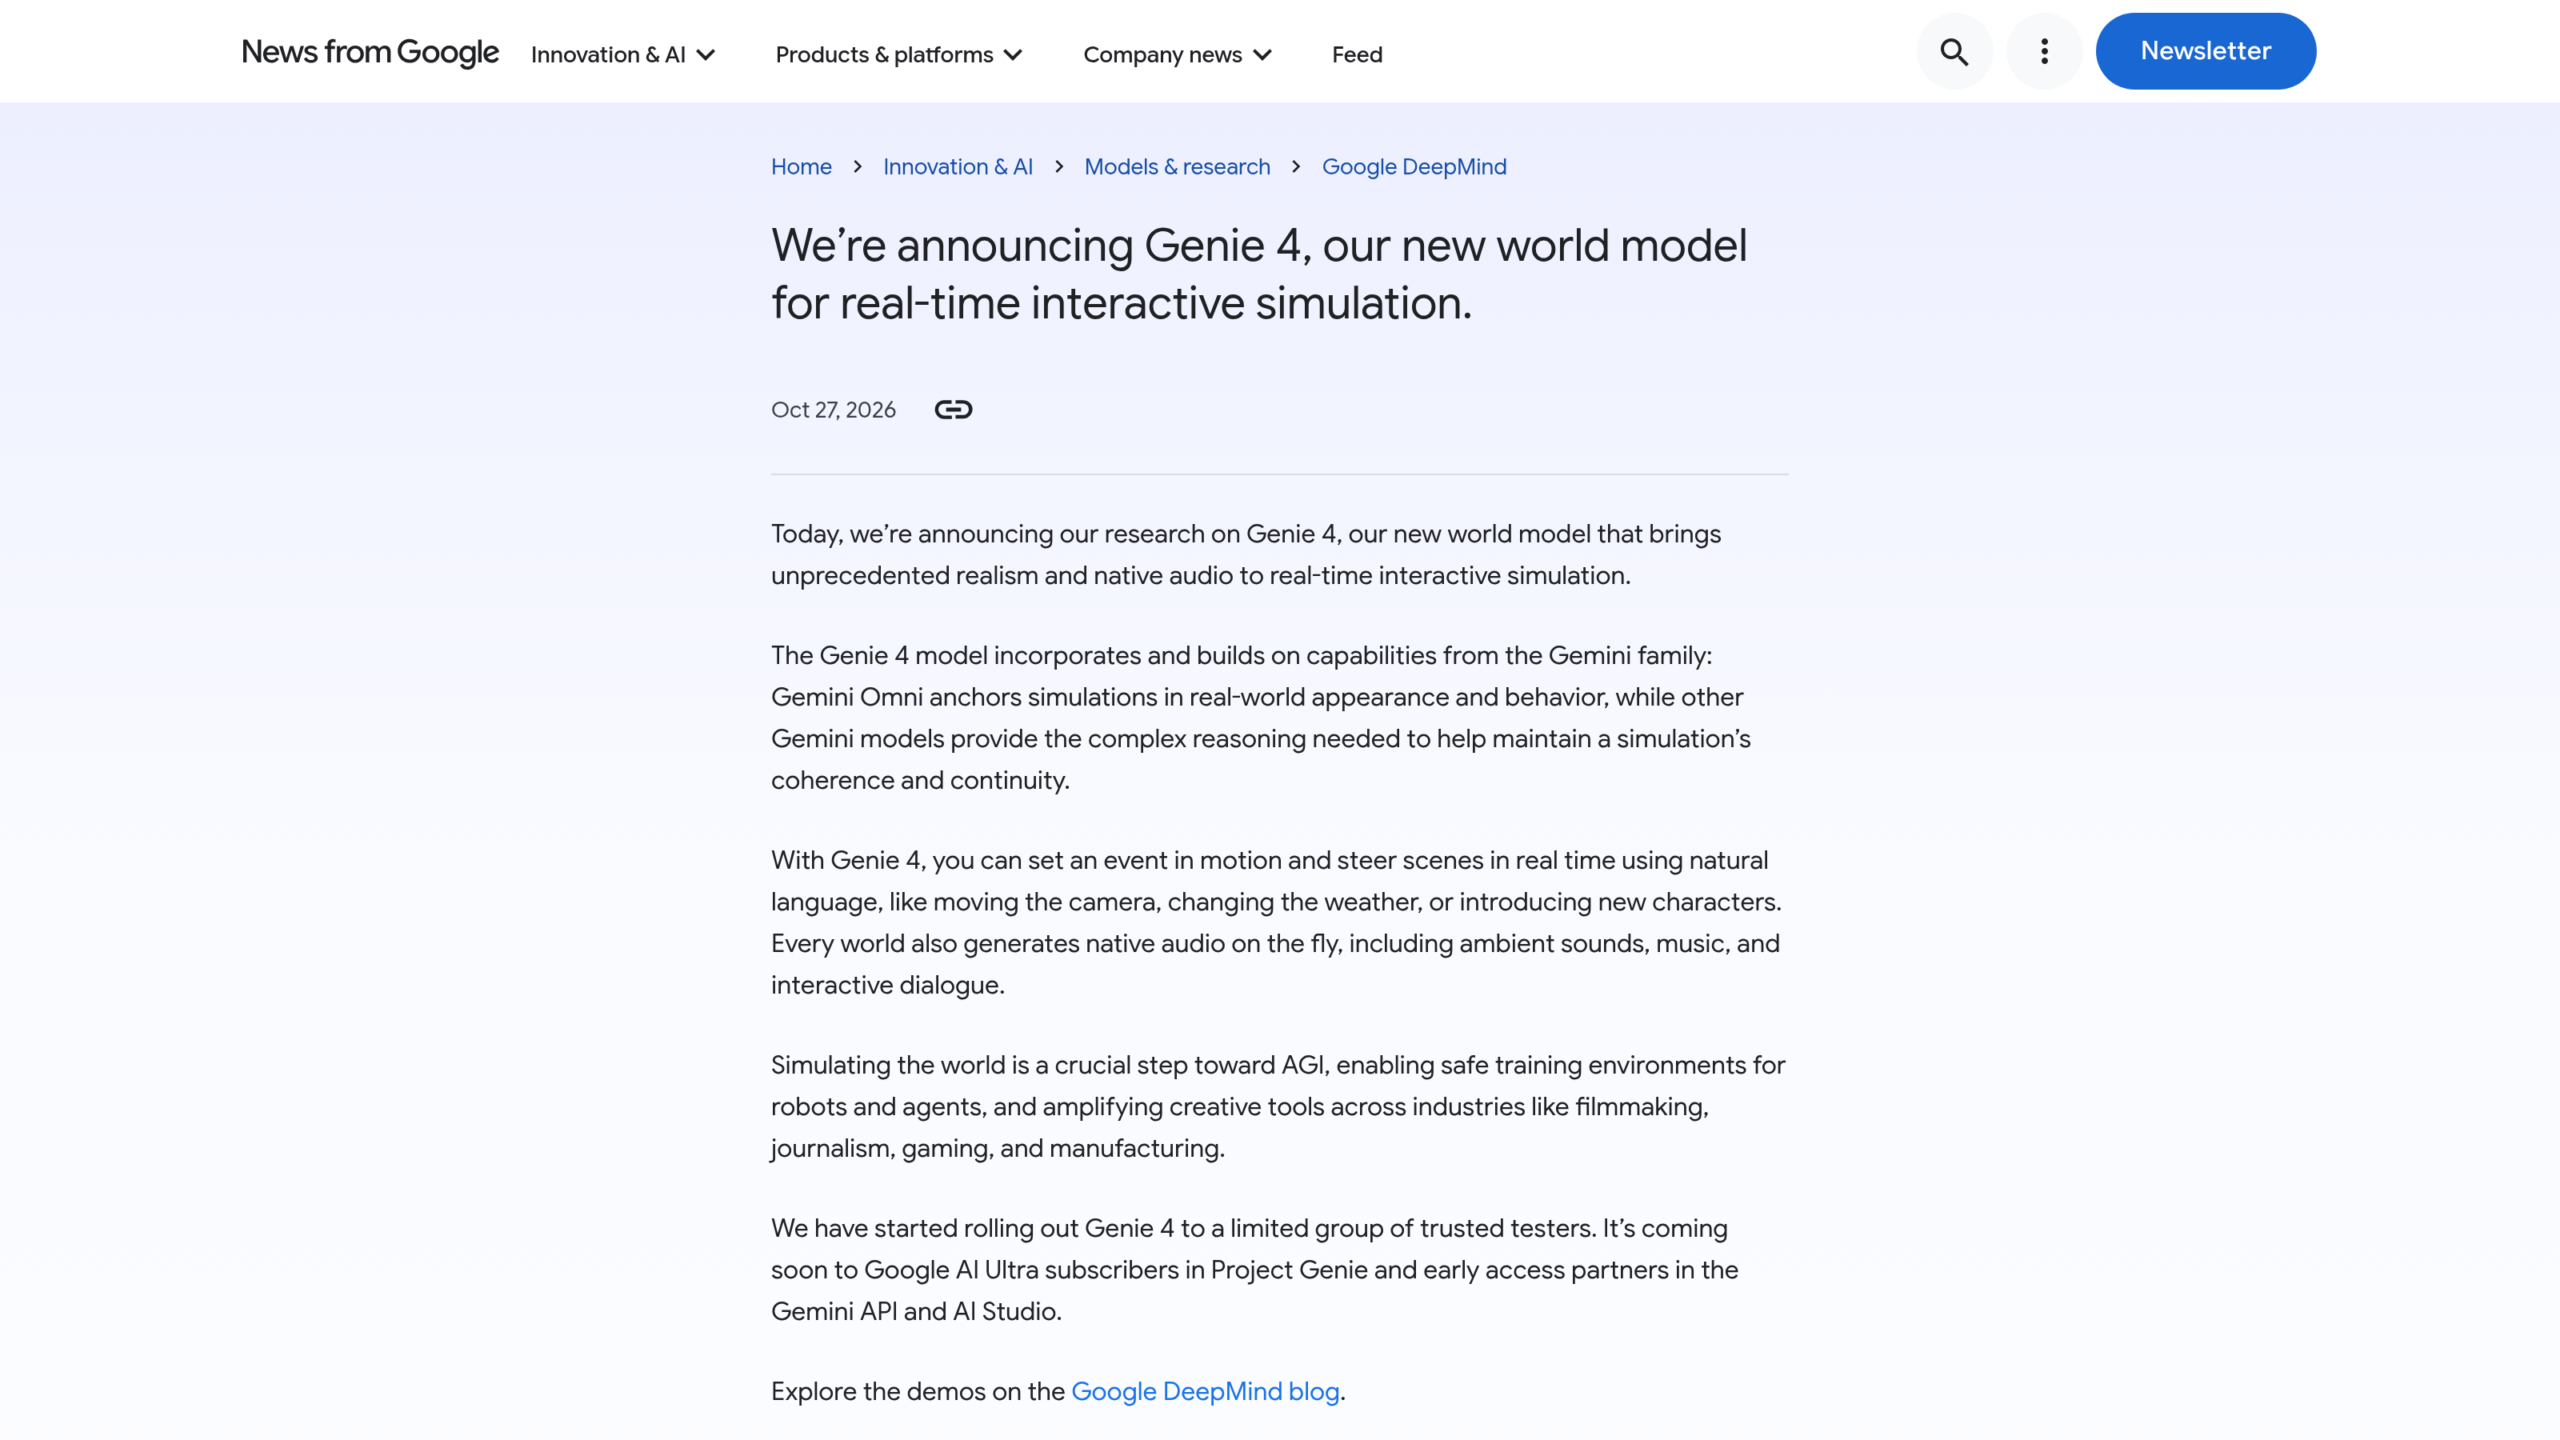
Le pilotage se fait de deux façons. Les touches du clavier déplacent le personnage et la caméra, et des phrases tapées en langage courant modifient la scène en cours de route : changer la météo, bouger la caméra, faire apparaître des personnages ou des objets. Pour garder l’ensemble cohérent, Gemini adapte ces consignes à la scène et surveille le monde entre deux commandes. Le modèle repose sur la famille Gemini : Gemini Omni ancre la simulation dans l’apparence et le comportement du monde réel, d’autres modèles Gemini fournissent le raisonnement qui garde la continuité.
Côté durée, Google ne donne aucun chiffre sur ses pages. C’est TechCrunch, sous la plume de Rebecca Bellan, qui rapporte une cohérence tenue jusqu’à deux minutes, soit le double de Genie 3. Cette valeur ne vient que de ce média : elle n’apparaît pas dans les billets de Google que j’ai lus. Aucune résolution ni cadence d’images n’est publiée non plus.
Les limites que Google reconnaît lui-même
Le billet est franc sur l’état du produit : « Genie 4 remains an early, evolving area of research » (Genie 4 reste un domaine de recherche jeune et en évolution). Les détails visuels et la permanence des objets, c’est-à-dire le fait qu’un arbre reste un arbre quand la caméra revient, peuvent dériver, surtout dans les longues sessions ou après plusieurs modifications au texte.
La liste des chantiers ouverts est longue : interactions physiques complexes, exactitude de l’audio en temps réel, texte lisible à l’écran, précision spatiale, cohérence sur la durée. Un joueur reconnaîtra là tout ce qui fait qu’un niveau tient debout, de la lisibilité d’un panneau à la position exacte d’une corniche. TechCrunch ajoute que Google n’a résolu ni l’exactitude de l’audio ni le texte lisible dans le monde généré.
Google précise aussi que tous les contenus générés, vidéo comme audio, porteront un filigrane SynthID (une marque invisible qui signale une création d’IA).
Pour les joueurs : un outil d’idées, pas un moteur de jeu
Dans les pages que j’ai lues, rien ne décrit de règles de jeu, de sauvegarde d’une partie ni d’export du monde vers un moteur. Ce sont des absences, pas des interdictions annoncées, mais elles dessinent l’usage actuel du modèle : une simulation qui s’explore pendant quelques minutes, pas un niveau qu’on rejoue demain. Le jeu vidéo figure d’ailleurs dans la liste des secteurs cités par Google, au même titre que le cinéma, le journalisme et l’industrie, et le billet insiste surtout sur l’entraînement de robots et d’agents.
Diego Rivas, ingénieur chez DeepMind, voit la valeur du temps réel dans les usages créatifs comme l’idéation et le storyboard, selon TechCrunch. C’est la lecture la plus plausible pour un studio : tester une ambiance, une météo ou un décor en tapant une phrase, avant de produire quoi que ce soit. Tejas Kulkarni, directeur de recherche chez Google, parle quant à lui de « hybrid world models » (modèles de monde hybrides) pour décrire l’association de Gemini et de Genie.
Le précédent est proche. Google Playground génère déjà des jeux à partir d’un prompt, et nous avions noté qu’il ne sort pas en France. Ce modèle se situe à l’étage d’avant, celui du croquis animé.
Quand l’essayer, et dans quel pays
Le billet publié sur le blog de Google le dit sans détour : le déploiement a commencé auprès d’un groupe limité de testeurs de confiance, et le modèle arrive bientôt chez les abonnés Google AI Ultra dans Project Genie, puis chez des partenaires en accès anticipé dans l’API Gemini et Google AI Studio. TechCrunch parle d’un déploiement « dans les prochaines semaines », sans calendrier plus précis. Une liste d’attente est ouverte sur la page de DeepMind.
Reste ce que personne n’a écrit : ni le prix de l’abonnement ou de l’API pour ce modèle, ni la date, ni la disponibilité en France. Google ne cite aucun pays dans ses pages. Le schéma ressemble à celui de Claude Duet, sans date pour la France, et la prudence est la même : tant qu’une page officielle ne liste pas les pays, un joueur français n’a rien à prévoir. La liste d’attente est le seul geste utile pour l’instant.
0 Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !