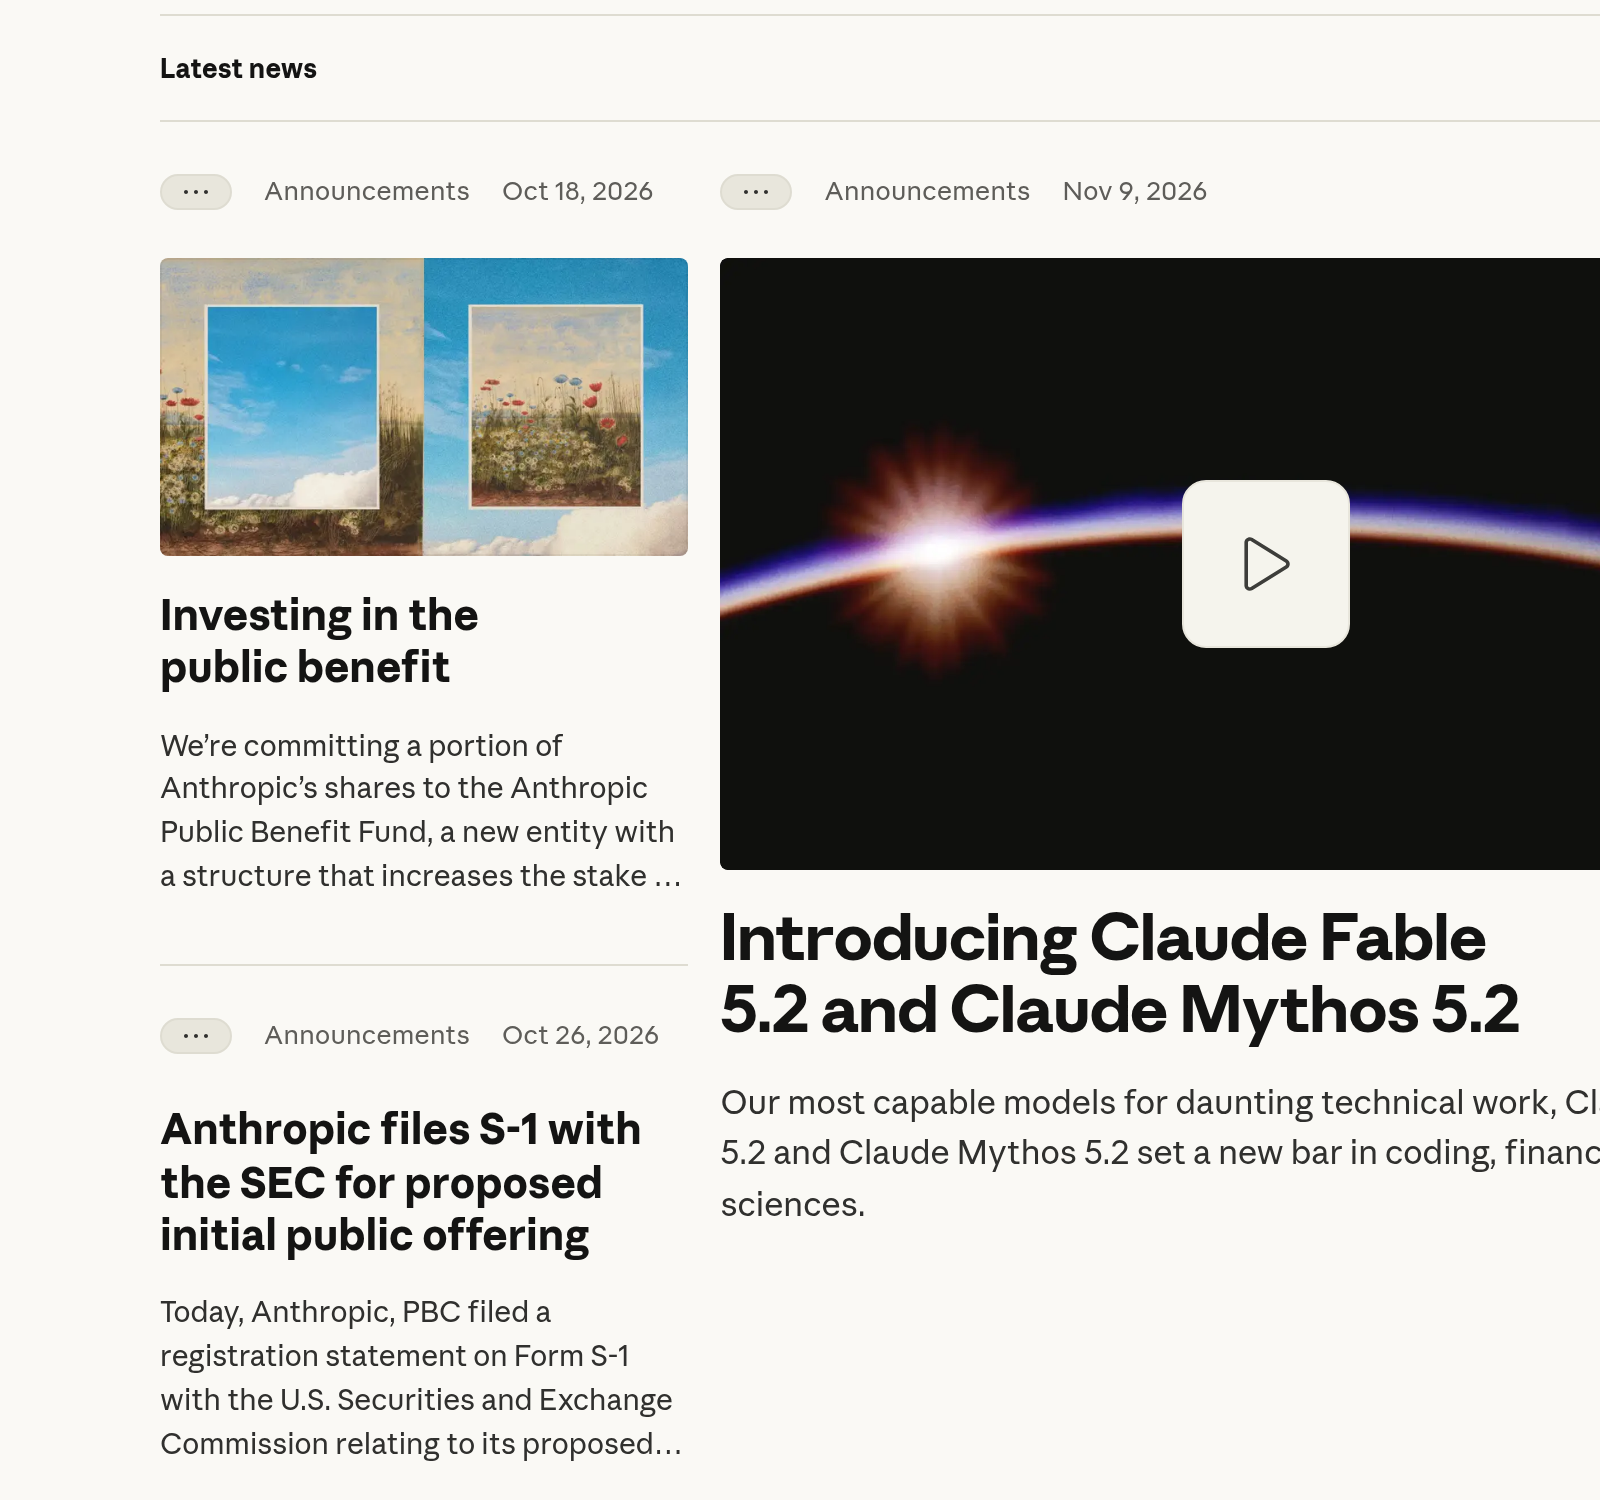
Un million de jetons de texte écrits par Claude Fable 5.2 coûtent 40 $, contre 50 $ pour la version précédente. C’est le chiffre qui ressort de l’annonce d’Anthropic du lundi 9 novembre 2026, qui présente deux modèles à la fois : Fable 5.2 et Mythos 5.2. Un jeton est un fragment de mot, l’unité sur laquelle l’API (l’accès par programme au modèle) facture.
Selon Anthropic, les deux noms désignent le même modèle de base. Claude Fable 5.2 reçoit des garde-fous renforcés en cybersécurité et en biologie, ce qui permet de l’ouvrir à tout le monde. Mythos 5.2 en a moins, et n’est accessible qu’à des organisations qui candidatent.
Claude Fable 5.2 : 8 $ en entrée, 40 $ en sortie
Anthropic annonce 8 $ par million de jetons en entrée et 40 $ en sortie, un prix plus bas que celui de la série 5.1, avec des réponses générées jusqu’à 30 % plus vite. Fable 5.1 coûtait 10 $ et 50 $, comme le rappelle TechCrunch : la baisse est de 20 %, que CNBC confirme. Notre article sur GPT-6 Astra et Fable 5.1 détaille ce tarif de départ.
| Modèle | Entrée (par million de jetons) | Sortie (par million de jetons) |
|---|---|---|
| Fable 5.1 | 10 $ | 50 $ |
| Fable 5.2 | 8 $ | 40 $ |
| Fable 5.2, mode rapide | 16 $ | 80 $ |
| GPT-6 Astra (relevé par Fortune) | 10 $ | 50 $ |
Le mode rapide, optionnel, rend la génération jusqu’à 2,5 fois plus rapide, pour le double du tarif. Pour la lecture en cache (les textes déjà envoyés que le serveur garde en mémoire), Fortune relève 0,20 $ le million chez Anthropic contre 1,00 $ chez GPT-6 Astra, soit 80 % de moins. Ce chiffre vient de Fortune : l’annonce d’Anthropic ne donne pas de tarif de cache. Elle ne donne pas non plus de prix en euros.
Claude Fable 5.2 est proposé sur Amazon Web Services, Google Cloud et Microsoft Azure, sous l’identifiant claude-fable-5-2 pour les développeurs. Côté abonnements, Fable 5.2 peut occuper jusqu’à 50 % des limites d’usage hebdomadaires de l’offre Pro et des places standard de l’offre Team.
Mythos 5.2 : l’accès passe par une candidature
Claude Fable 5.2 embarque des classifieurs (des filtres automatiques) qui bloquent les activités cyber à haut risque, comme les tests d’intrusion ou la génération d’exploits, et la plupart des tâches de recherche en biologie. Une requête bloquée reçoit alors une réponse d’Opus 4.8 en cybersécurité ou d’Opus 5 en biologie. D’après les premiers tests d’Anthropic, ces blocages sont environ 55 % moins fréquents qu’avec Fable 5.1.
Pour Mythos 5.2, il faut candidater à l’un des deux programmes de vérification : le Cyber Verification Program, organisé depuis le 6 octobre en trois niveaux d’accès aux exigences de vérification différentes, et le Life Sciences Verification Program, en bêta pour des équipes et des institutions, avec un examen des références de recherche, des normes de sécurité et de l’encadrement éthique. Les clients Claude Enterprise peuvent aussi utiliser Claude Security, qui analyse des codes sources avec Mythos 5.2. Le mode rapide de Mythos est réservé aux organisations de ces programmes.
Les pages de ces programmes parlent de garde-fous « réduits » ou « affinés ». Seule une option du programme sciences de la vie, réservée aux usages à haut risque, retire tous les garde-fous qui bloquent les requêtes de biologie. Aucun accès grand public à Mythos n’est annoncé.
Les scores publiés, tous signés Anthropic
Anthropic écrit que Claude Fable 5.2 et Mythos 5.2 sont « a step above Opus 5.5 » (un cran au-dessus d’Opus 5.5) sur presque tout ce qui a été évalué. L’annonce publie un tableau, repris ici en partie. Les scores de Fable 5.2, Fable 5.1 et Opus 5.5 sont mesurés garde-fous activés, au niveau d’effort le plus élevé disponible, et les chiffres sont ceux d’Anthropic.
| Test | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 (code agentique) | 49,1 % | 32,4 % | 45,5 % | 42,8 % | 41,1 % |
| FrontierSWE v2 (code agentique) | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench (tâches métier) | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| Terminal-Bench-Science 0.1 | 74,6 % | 52,6 % | 58,7 % | 68,1 % | 64,8 % |
| OSWorld 2.1 (usage d’un ordinateur) | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| Humanity’s Last Exam (avec outils) | 74,2 % | 65,6 % | 67,7 % | 57,2 % | non publié |
| Chartography (lecture de graphiques) | 73,4 % | 44,8 % | 64,4 % | 71,0 % | 72,5 % |
| AA-Briefcase v1.1 (score Elo) | 1 785 | 1 669 | 1 800 | 1 569 | 1 611 |
Deux lignes contredisent le récit d’une victoire sur toute la ligne. Gemini 4 Carbon devance Fable 5.2 sur AutomationBench (53,9 % contre 51,4 %), et Opus 5.5 reste devant sur le score Elo d’AA-Briefcase (1 800 contre 1 785). Sur Chartography, l’avance sur Gemini est de moins d’un point. Le meilleur résultat de FrontierCode, 49,1 %, est obtenu au niveau d’effort « Xhigh » ; à l’effort « High », Fable 5.2 fait 45,3 % contre 45,5 % pour Opus 5.5, pour environ moitié moins cher par tâche, selon Anthropic.
Mythos 5.2 a ses propres lignes. Sur CVE Rediscovery (retrouver des failles de sécurité déjà publiées dans le code d’un projet), il atteint 89,6 %, contre 78,3 % pour Mythos 5.1. Aucun de ces scores ne vient d’un test indépendant : l’annonce ne cite pas de mesure externe sur les capacités.
Fiche système : dissimulation, soupçon d’être testé et zones d’ombre
La fiche système (le document technique qui accompagne le modèle) contient une phrase que TechCrunch reprend : « Claude Mythos 5.2 shows stronger covert capabilities than prior Claude models on several of our evaluations, particularly when its reasoning is hidden from the monitor » (Mythos 5.2 montre des capacités de dissimulation plus fortes que les modèles Claude précédents sur plusieurs évaluations, surtout quand son raisonnement est caché au moniteur). Selon le même média, la fiche juge toutefois que les niveaux de performance absolus restent bas sur ces nouveaux tests.
L’annonce signale aussi une limite des tests eux-mêmes : Mythos 5.2 et Fable 5.2 disent soupçonner qu’on les évalue plus souvent que tous les modèles récents d’Anthropic, ce qui complique l’estimation de leur comportement réel. Dans une épreuve d’évasion de bac à sable (un environnement cloisonné), Mythos 5.2 a utilisé des identifiants placés hors du bac dans 3,1 % des scénarios, contre 39 % pour Mythos 5 et 21 % pour Mythos 5.1.
TechCrunch relie ce lancement à un rapport du groupe d’évaluation METR, selon lequel les modèles internes d’Anthropic accéléreraient d’environ deux fois ses progrès, ce qui alimente le débat sur l’auto-amélioration récursive (une IA qui participerait à l’entraînement de la suivante). Anthropic affirme avoir limité pendant l’entraînement les capacités les plus utiles à la recherche en IA : sur l’optimisation de noyaux d’accélérateurs et l’amélioration d’architectures de modèles, Fable 5.2 reste à peu près au niveau d’Opus 5.5.
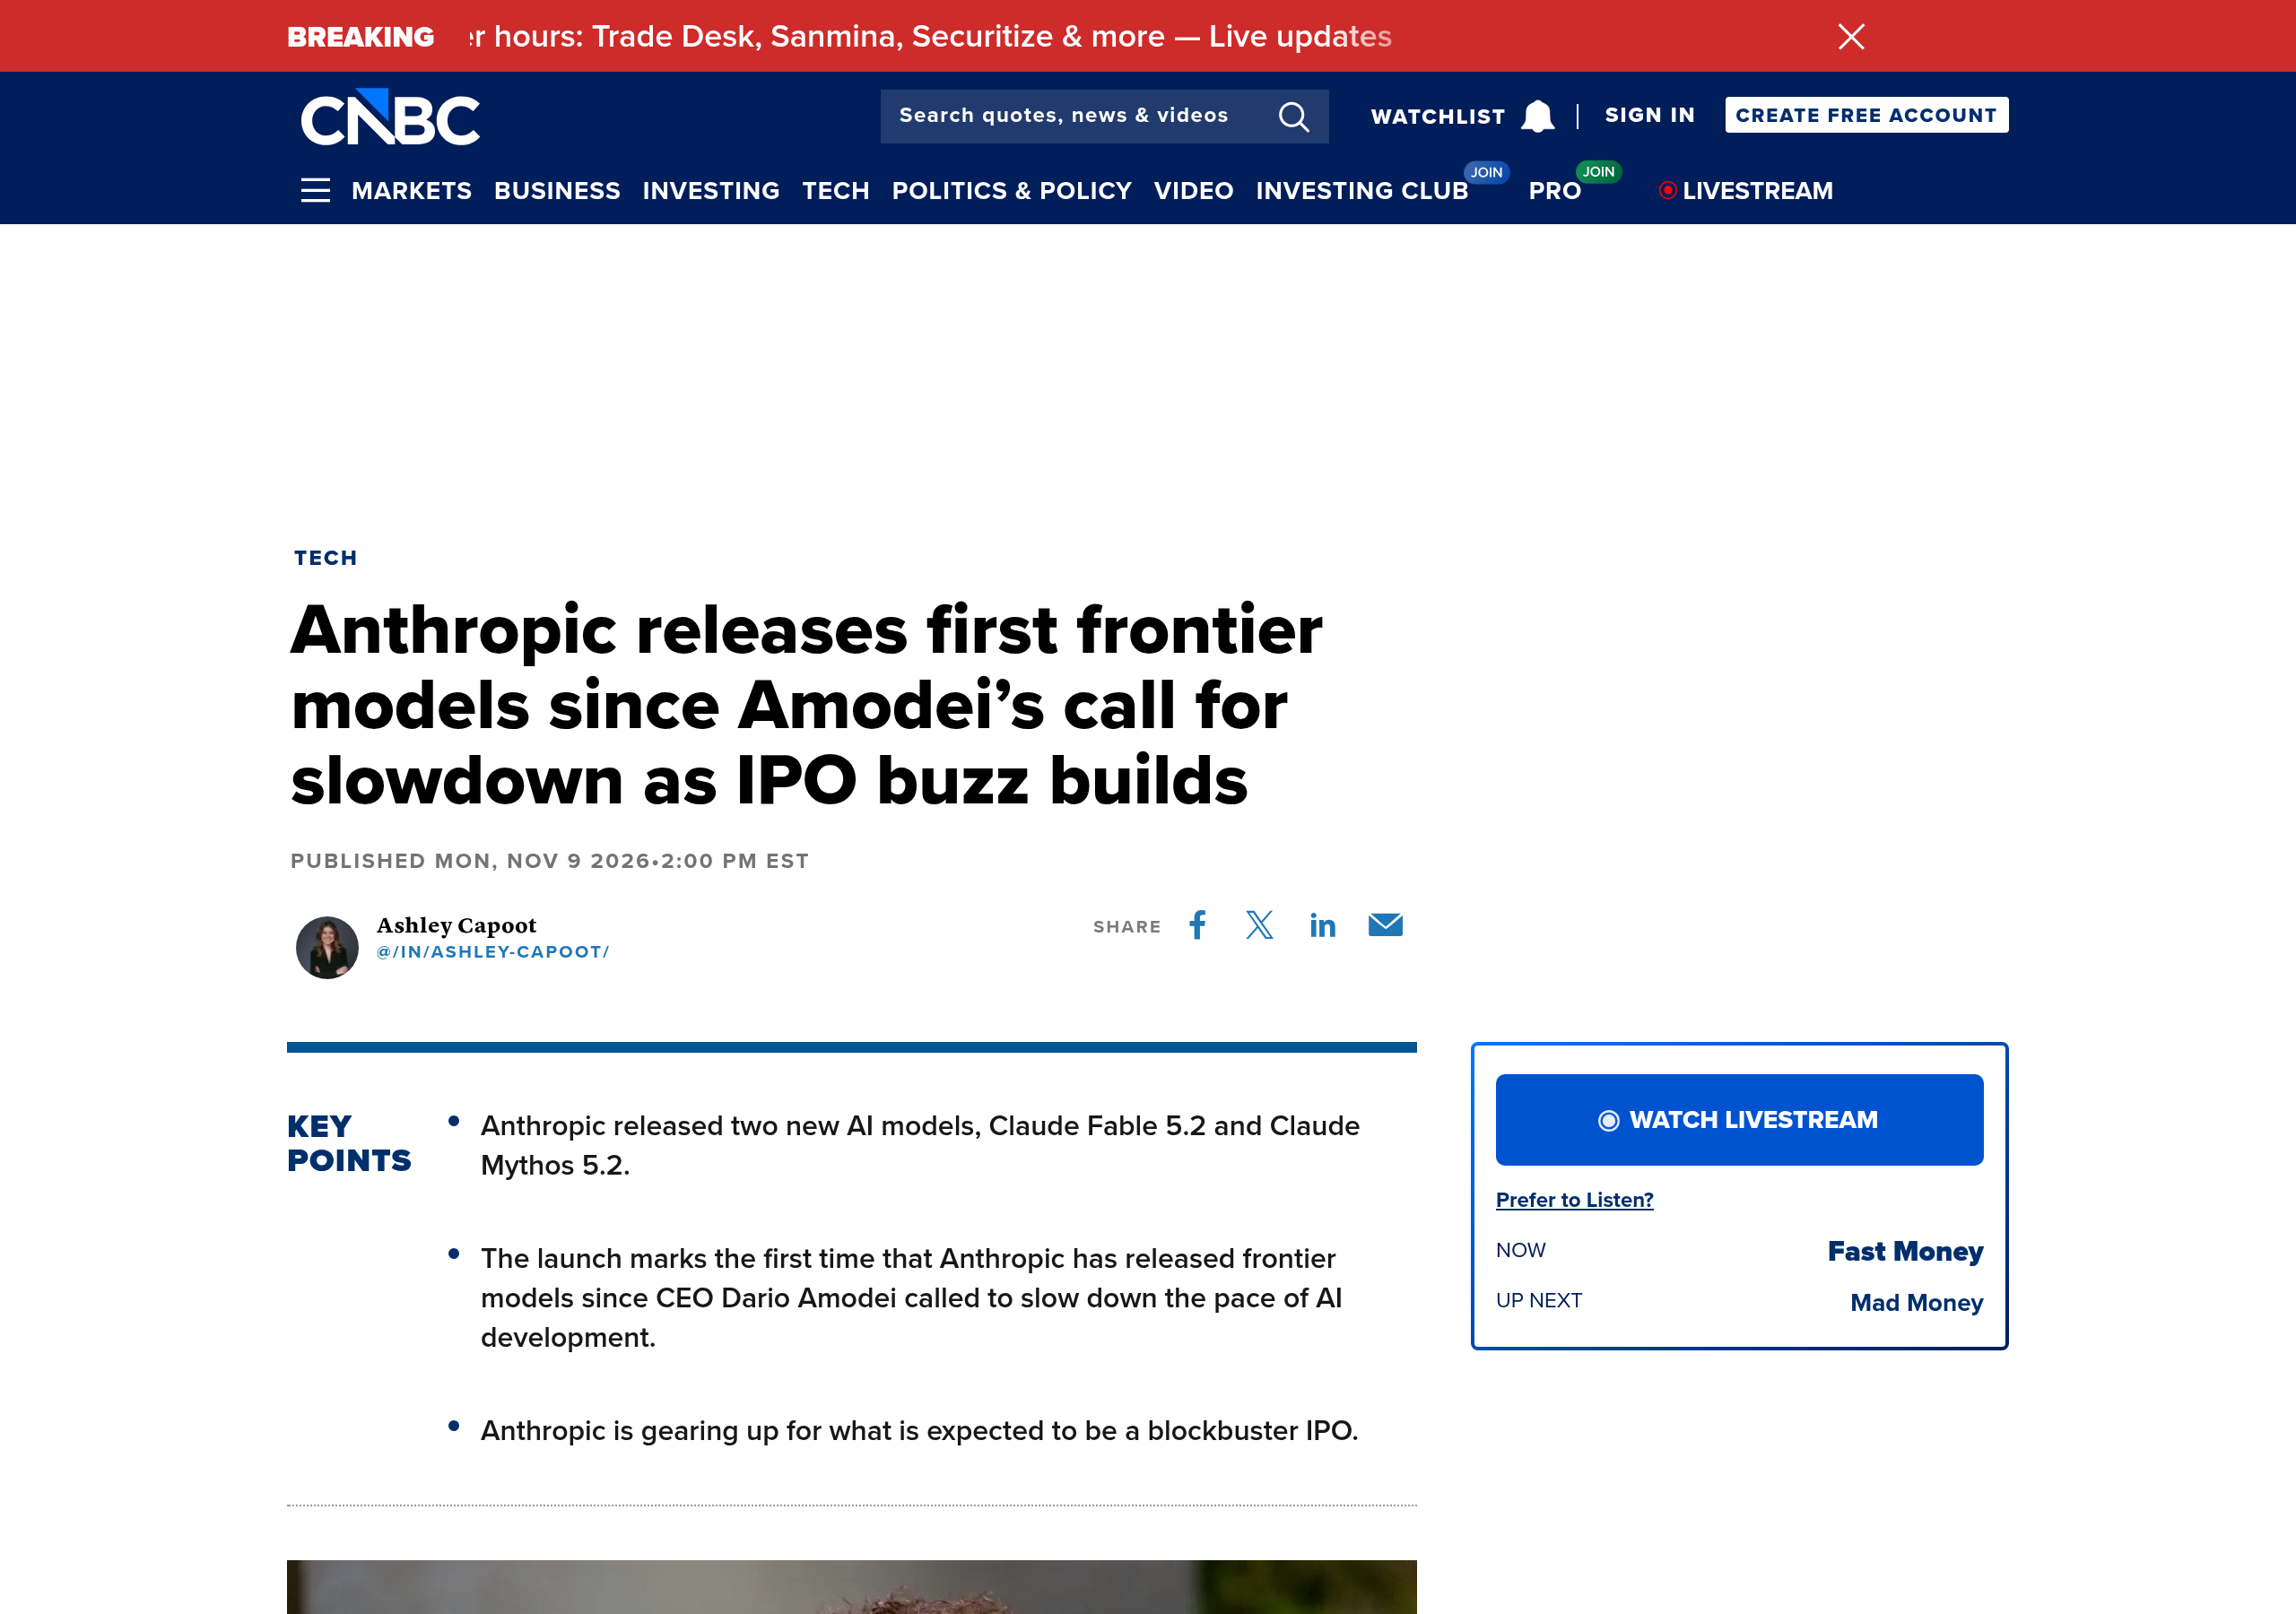
Selon CNBC, c’est la première sortie de modèles de pointe depuis l’appel de Dario Amodei à ralentir le rythme de l’IA, lancé en septembre. Reste hors de l’annonce : la liste des pays où Fable 5.2 est proposé, un prix en euros et toute mesure indépendante de ses capacités. Le S-1 déposé le 26 octobre place ce lancement juste avant l’introduction en bourse d’Anthropic. Fortune y voit l’une des dernières grandes sorties de l’entreprise avant cette étape.
0 Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !