1 050 milliards de paramètres au total, 52 milliards qui travaillent à chaque mot, un million de tokens de contexte et un surnom d’argot anglais : « le chonk » désigne quelque chose de gros et de costaud. Le 6 octobre 2026, Mistral a ouvert l’accès à Mistral Large 4 en préversion publique, avec des poids que l’entreprise française promet de publier avant la fin du mois.
Les performances citées plus bas sont celles que Mistral revendique : aucune mesure indépendante n’a encore été publiée, et le modèle ne s’utilise pour l’instant que par l’API de l’entreprise.
Ce que Mistral Large 4 active à chaque mot
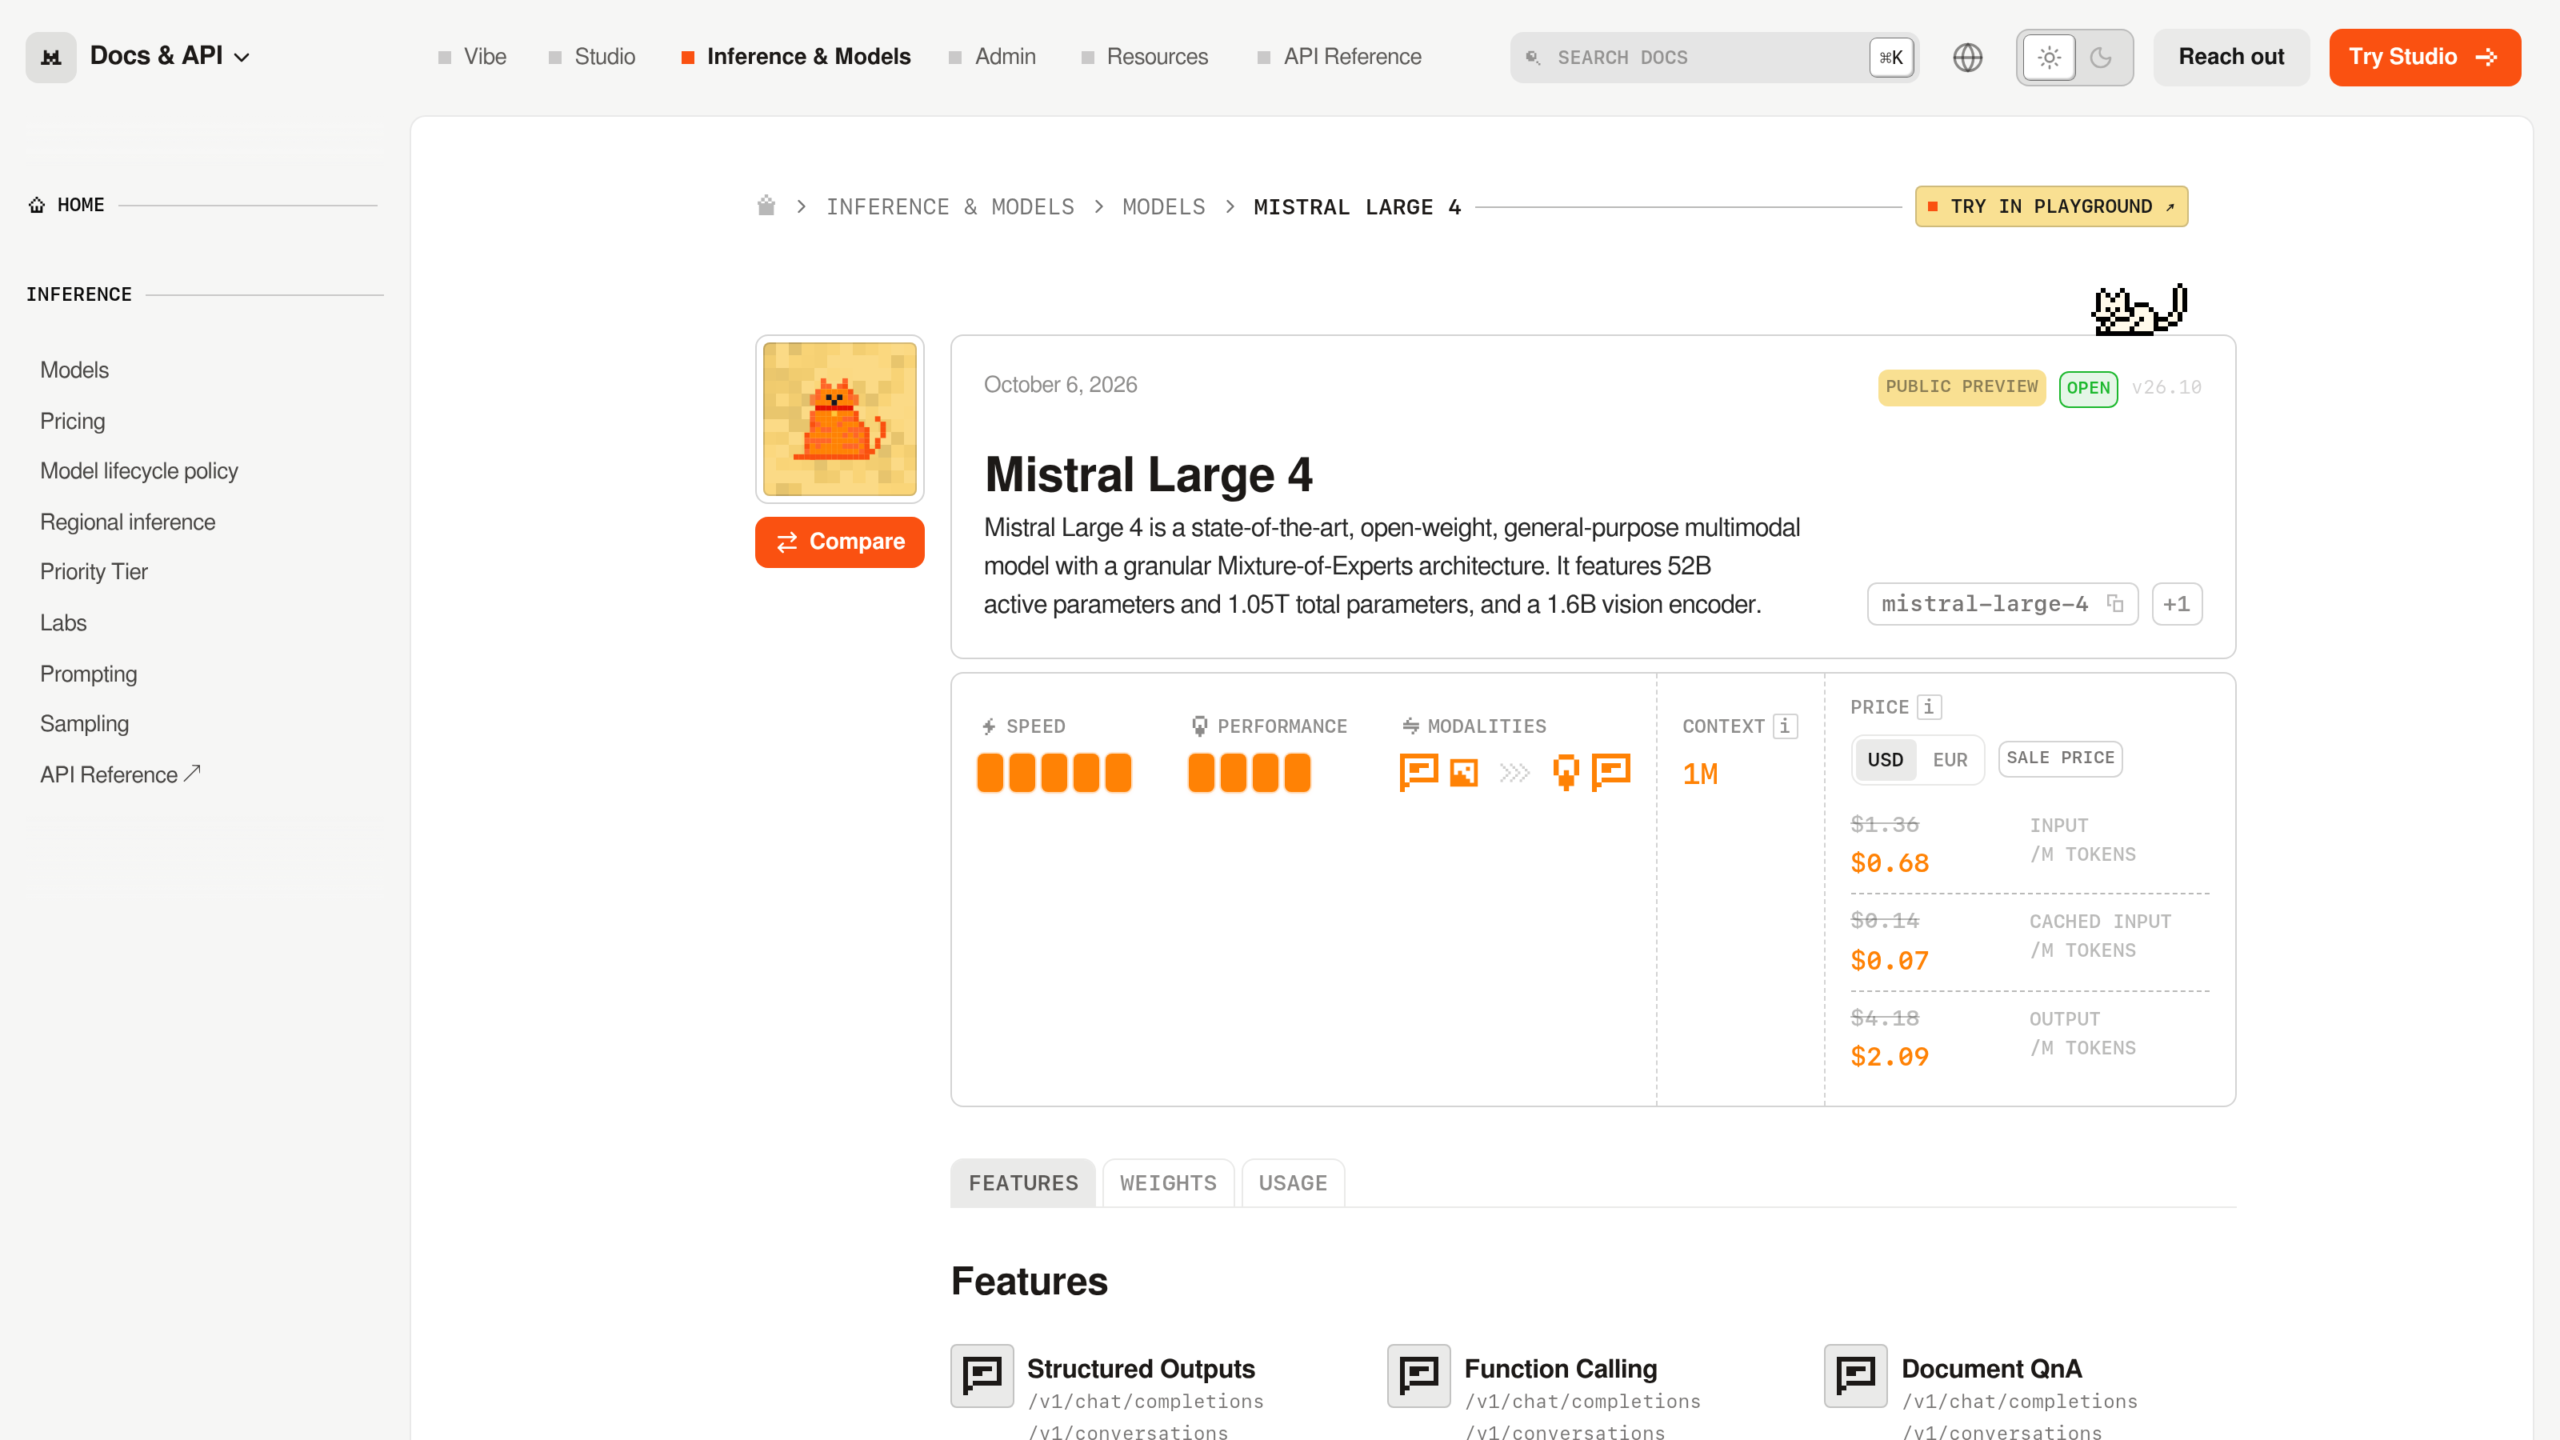
La fiche technique de Mistral décrit une architecture « Granular Mixture-of-Experts », en français un mélange d’experts : le modèle contient une multitude de sous-réseaux spécialisés, et seule une petite partie d’entre eux se réveille pour produire chaque mot. D’où l’écart entre les 1,05 billion (1 050 milliards) de paramètres du modèle entier et les 52 milliards sollicités à chaque étape. Un encodeur de vision de 1,6 milliard de paramètres complète l’ensemble, ce qui rend le modèle multimodal : il lit aussi les images.
La même fiche affiche un contexte de 1 million de tokens (l’équivalent de plusieurs romans lus d’un coup), la version v26.10 et l’identifiant d’API mistral-large-4. Mistral annonce plus de 160 langues, dont toutes les langues officielles de l’Union européenne. L’entraînement a mobilisé 3 800 GPU Nvidia Grace Blackwell dans les centres de données européens de l’entreprise. Pour TechCrunch, c’est deux à trois fois moins de puces que chez les concurrents chinois, d’après ce que rapporte le média.
49 ou 52 milliards de paramètres actifs
Les sources ne donnent pas le même chiffre. La fiche officielle indique 52 milliards de paramètres actifs. AlternativeTo (article de Paul, 7 octobre) et TestingCatalog (6 octobre) écrivent 49 milliards. Le chiffre officiel fait foi : c’est 52.
Aucune des sources lues n’explique l’écart. Une hypothèse plausible, que rien ne confirme : les 49 milliards excluraient l’encodeur de vision ou une partie partagée du réseau. Tant que Mistral ne tranche pas, citez 52.
Poids ouverts : ce qui est promis, ce qui manque
« Poids ouverts » veut dire que les fichiers du modèle sont publiés : n’importe qui peut les télécharger et les faire tourner sur ses propres machines, sans passer par l’API de l’éditeur. La fiche de Mistral porte la mention « OPEN », mais les poids ne sont pas encore disponibles. Dans son annonce, Mistral écrit que les poids sortiront à la fin d’octobre. TechCrunch parle de trois semaines après la fin des tests de sécurité. Certains médias avancent le 27 octobre : aucune des sources lues ne le confirme.
Deux informations manquent. La licence n’est précisée ni dans l’annonce ni chez TechCrunch, et elle décidera de ce qu’une entreprise a le droit de faire du modèle. Aucune source ne chiffre non plus la mémoire nécessaire pour l’héberger. Avec 1 050 milliards de paramètres, il est hors de portée d’un PC grand public, mais sans chiffre officiel, mieux vaut ne pas en inventer un. Pierre Stock, vice-président science de Mistral, dit à TechCrunch que l’entreprise travaillera avec des partenaires de confiance et des gouvernements pour que les poids servent à défendre, pas à attaquer.
Le prix face à OpenAI Sol
Le tarif plein de l’API est de 1,36 $ par million de tokens en entrée et 4,18 $ en sortie. La fiche technique du 8 octobre affiche des prix en promotion, deux fois moins élevés : 0,68 $ en entrée, 0,07 $ pour une entrée déjà en cache (au lieu de 0,14 $) et 2,09 $ en sortie. La durée de la promotion n’est pas indiquée.
Pour situer ces tarifs, OpenAI facture son modèle GPT-6.1 Sol 2 $ en entrée et 10 $ en sortie par million de tokens, selon son annonce du 29 septembre relayée dans cet article. Au tarif plein, Mistral demande donc environ un tiers de moins en entrée et 58 % de moins en sortie. En promotion, l’écart passe à un facteur d’environ 3 en entrée et d’environ 5 en sortie. Les deux modèles ne jouent pas forcément dans la même catégorie : la comparaison ne porte que sur le prix affiché.
Côté performances, Mistral met en avant 61,7 % sur DeepSWE v1.1 (programmation) et 93 % sur Cybench (cybersécurité). Sur un test de vision, le Dense 200, il affiche 42 % contre 41 % pour GPT-6-Astra. Ces scores viennent de l’entreprise elle-même. Ce lancement est le premier jalon de la levée de 3 milliards d’euros que Mistral présente comme la plus grosse d’une entreprise tech européenne, et il arrive alors que d’autres acteurs, comme Nvidia et Perplexity, publient eux aussi des modèles à poids ouverts. Les poids de fin octobre diront si le « chonk » tient ses promesses hors du laboratoire.
0 Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !