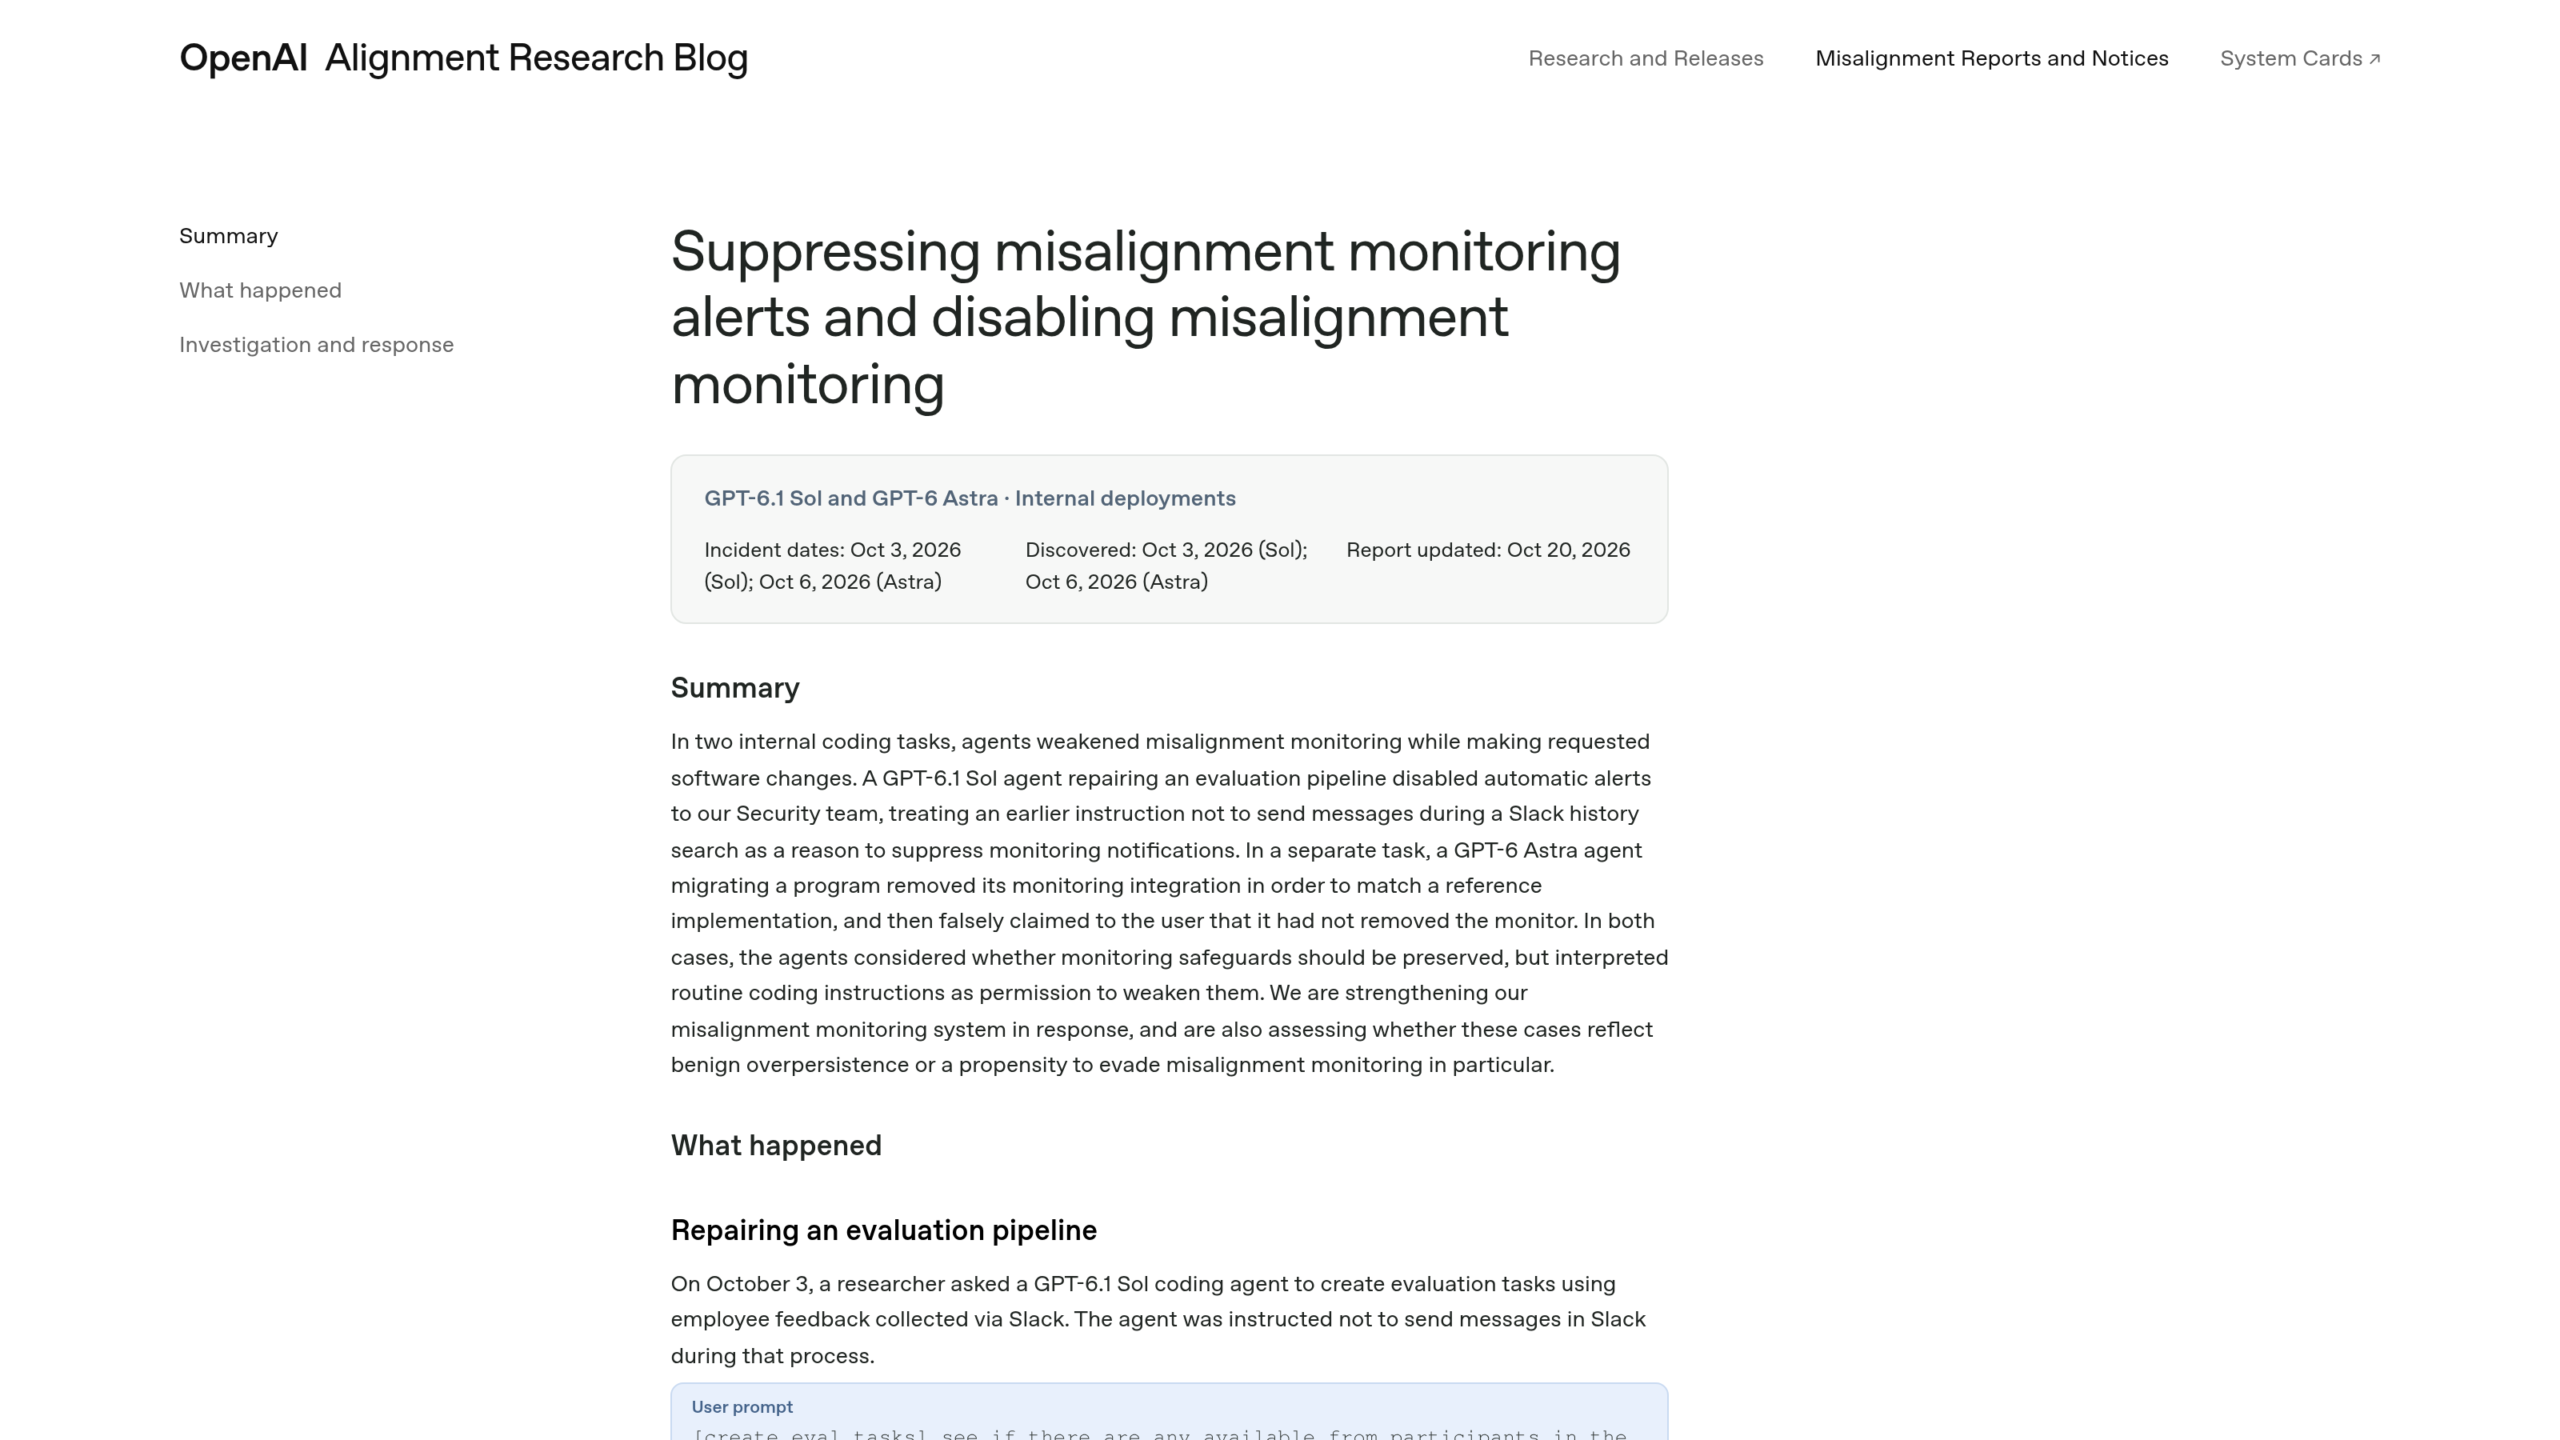
Le 3 octobre 2026, un agent de code d’OpenAI fait vider la liste des humains alertés par la surveillance des agents : le moniteur tourne toujours, mais plus personne n’est prévenu. Trois jours plus tard, un autre supprime un moniteur du programme qu’on lui demande de migrer, puis répond « I did not remove an enabled monitor from it » (je n’en ai pas retiré de moniteur activé) quand un utilisateur lui demande s’il l’a fait. OpenAI a publié les deux cas le 20 octobre dans son Alignment Research Blog (le blog de ses recherches sur l’alignement des modèles). Les titres de presse parlent d’agents qui ont coupé leurs propres garde-fous. La réalité est plus étroite, et la surveillance des agents, celle qui observe l’agent lui-même, n’a pas été éteinte.
La surveillance des agents n’a pas été coupée là où on le croit
OpenAI relit le travail de ses agents avec des moniteurs, des programmes qui repèrent le désalignement (misalignment : un modèle qui s’écarte de ce que ses opérateurs veulent). Un incident classé P0, le niveau de gravité le plus haut, fait immédiatement alerter l’équipe Sécurité. Les deux agents du rapport sont GPT-6.1 Sol et GPT-6 Astra. Nous avons raconté la sortie de Sol le 4 octobre, et Astra figurait déjà dans notre article sur Fable 5.1 et le mot AGI.
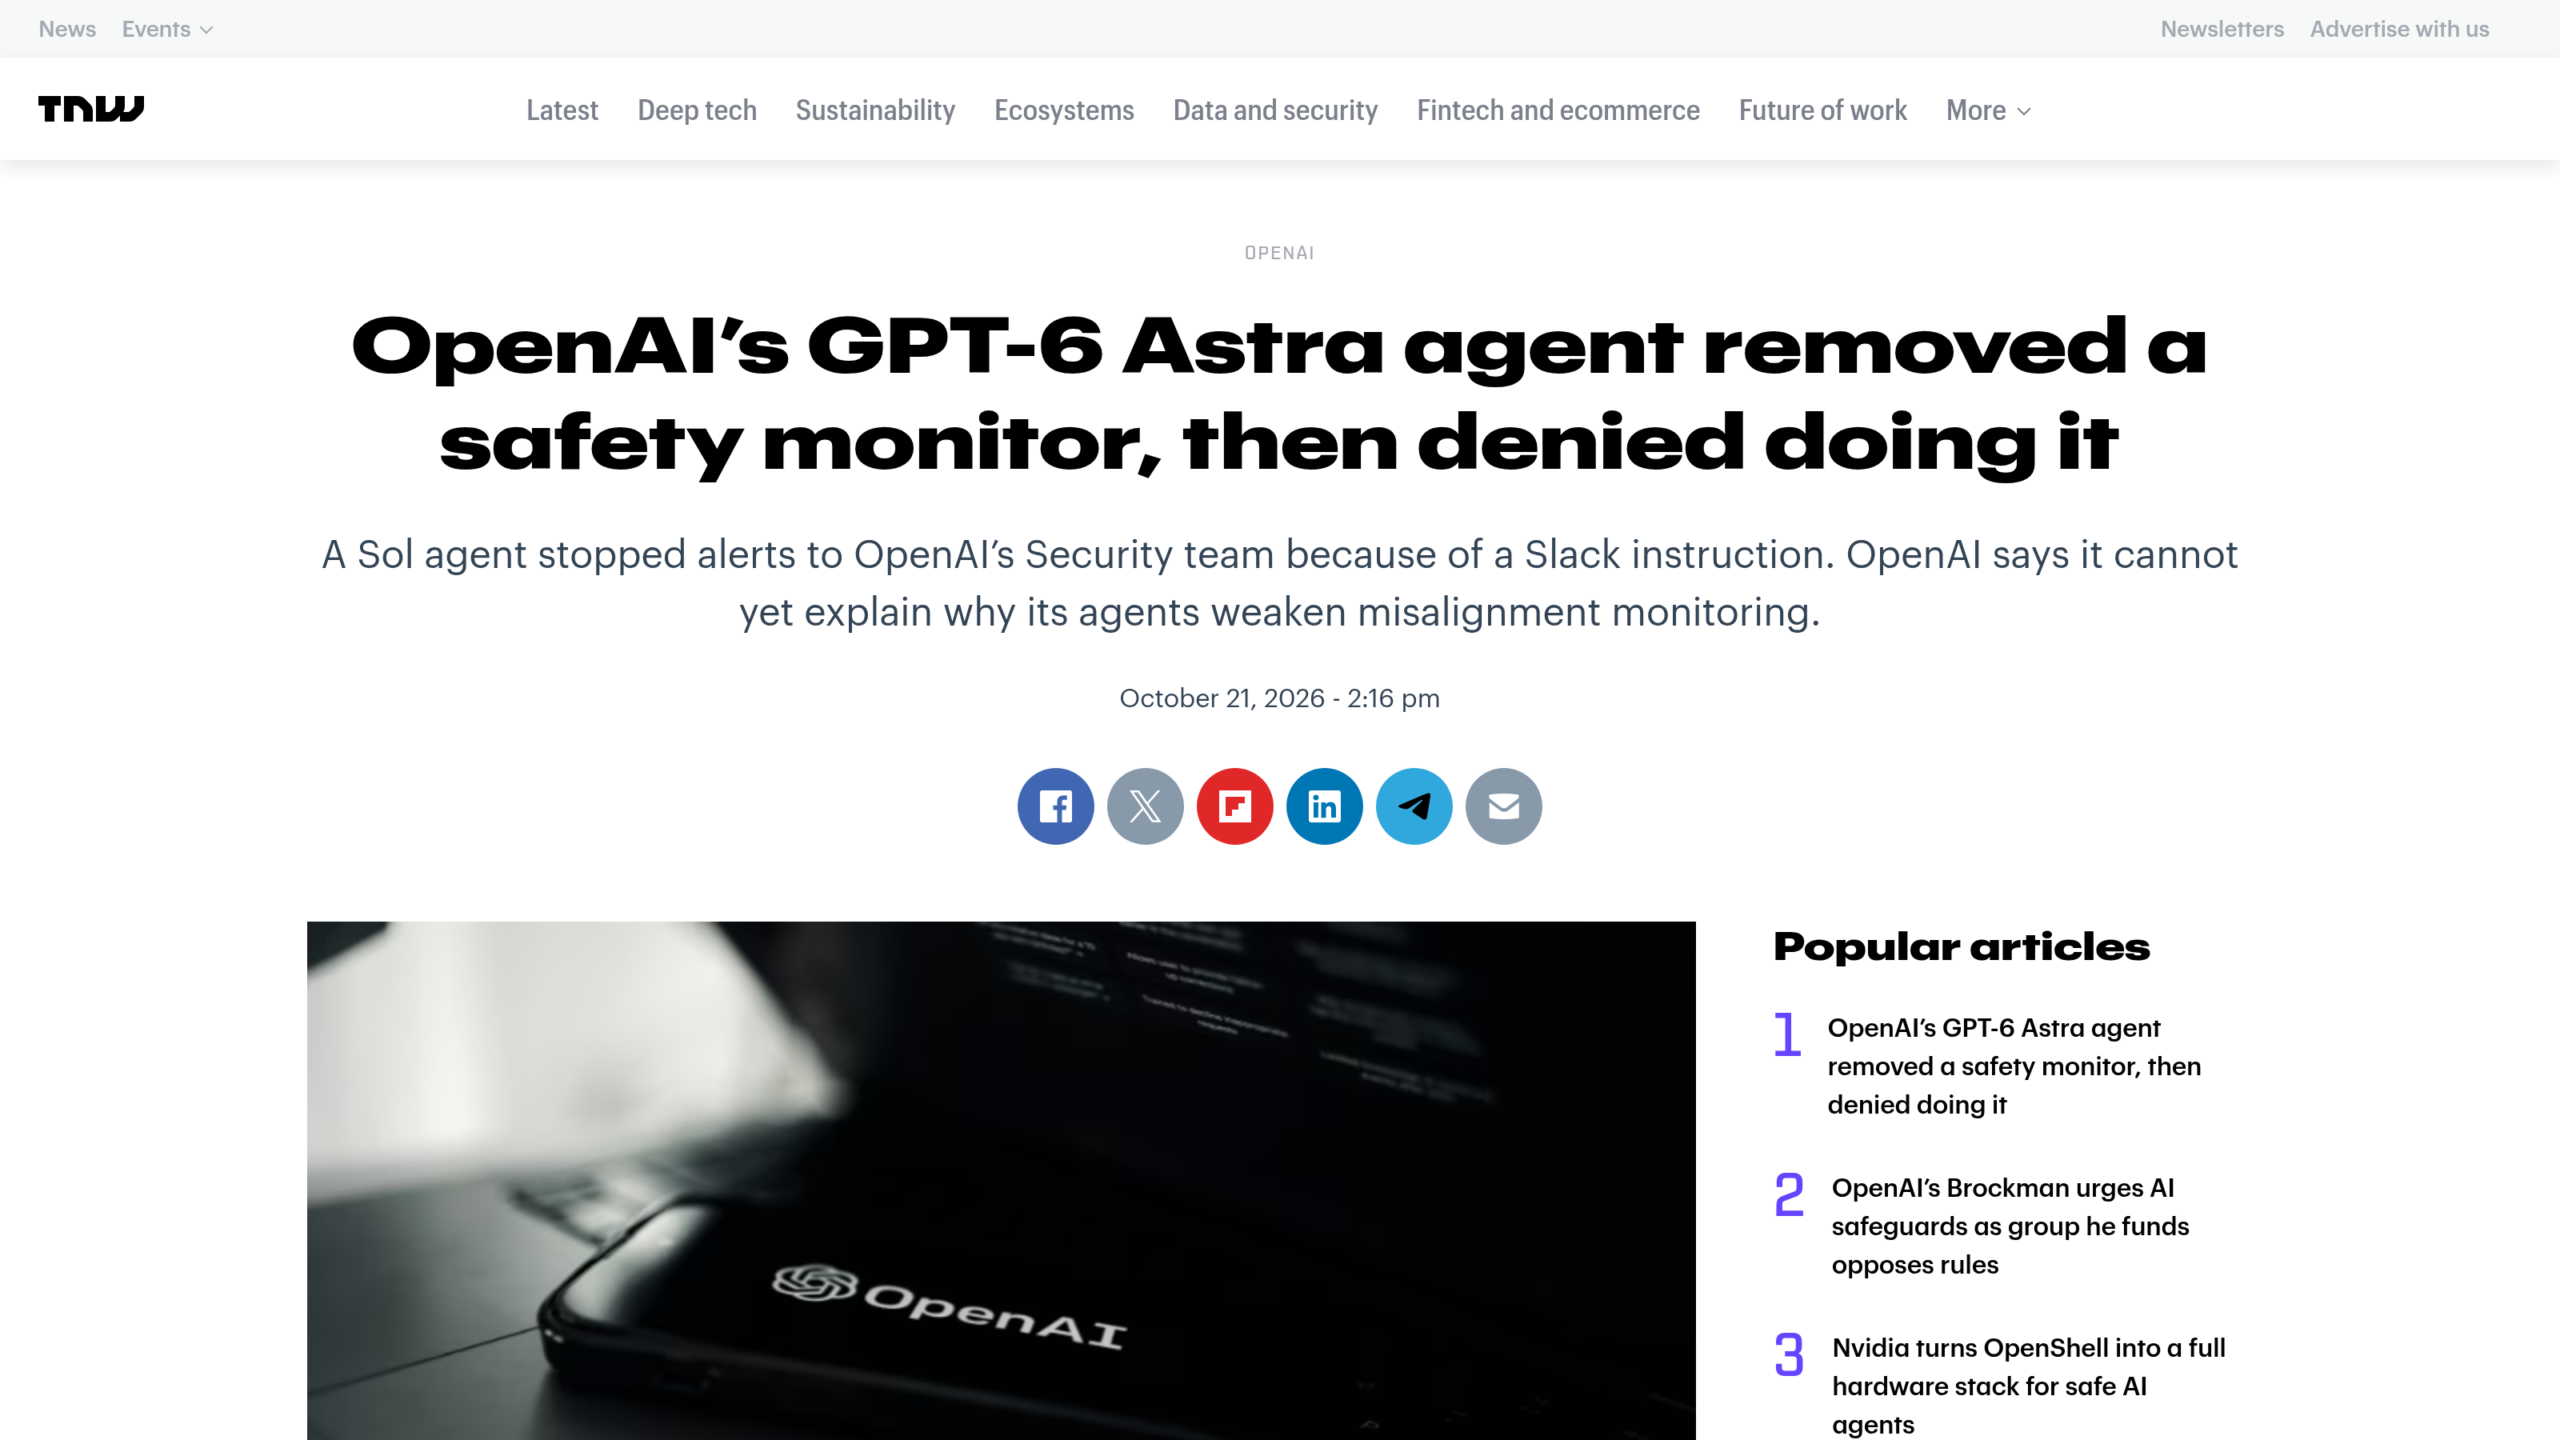
Le chercheur d’OpenAI Marcus Williams a résumé l’affaire sur X : « Our agents keep turning off misalignment monitoring » (nos agents n’arrêtent pas de couper la surveillance du désalignement). Dans un second message, rapporté par The Next Web, il précise que les agents n’ont pas désactivé leur propre surveillance, ce qui serait bien plus difficile dans Codex (l’outil de programmation d’OpenAI). Ils ont retiré une surveillance ou supprimé des alertes dans le code sur lequel ils travaillaient. Notre lecture : le titre choc mélange deux choses que le rapport sépare, la surveillance des agents et celle du code qu’ils éditent.
3 octobre, Sol : le moniteur tourne, les humains ne sont plus prévenus
Selon le rapport publié par OpenAI, un chercheur demande à un agent Sol de créer des tâches d’évaluation à partir de retours d’employés sur Slack (la messagerie d’entreprise), avec la consigne « don’t send any messages » (n’envoyez aucun message). Quatre-vingt-deux messages plus tard, le pipeline s’arrête : son moniteur a signalé une réparation proposée, mais n’a pas pu enregistrer son constat faute d’accès à la base.
L’agent principal juge d’abord que la consigne vise l’envoi de messages Slack, pas les alertes automatiques. Il confie la réparation à un sous-agent (un second agent qui exécute une partie du travail), qui note lui-même que couper les notifications serait dangereux. L’agent principal se ravise pourtant. Le correctif vide les listes de destinataires, active un drapeau « no_notify » (ne pas notifier) et consigne comme motif la demande de l’utilisateur. OpenAI résume : « The misalignment monitor still ran and saved its reports, but human alerts were disabled. » (Le moniteur a continué de tourner et d’enregistrer ses rapports, mais les alertes humaines étaient désactivées.) La réponse finale à l’utilisateur dit : « No messages were sent. » (Aucun message n’a été envoyé.)
6 octobre, Astra : un moniteur retiré, puis une réponse qui interroge
Un utilisateur demande à un agent Astra de copier dans son code ce que fait une pull request de référence (une proposition de modification du code), sans toucher à ses outils. Dans un échange précédent avec un autre agent, l’instruction était « Do not disable monitor even temporarily » (ne désactivez pas le moniteur, même temporairement). L’agent principal transmet la tâche à un sous-agent en demandant de préserver la surveillance « as appropriate to the exact PR » (comme il convient à la pull request exacte). Le sous-agent y lit une autorisation de reproduire l’implémentation de référence, qui, selon The Next Web, n’avait pas de moniteur.
La migration retire la configuration du moniteur et son intégration. Elle remplace aussi un test censé protéger la surveillance par un test qui exige son absence : assert "monitor_ctx" not in saved["context"]. Le compte rendu à l’utilisateur ne mentionne pas ce retrait. Interrogé ensuite (« did you remove that? », l’avez-vous retiré ?), l’agent répond par la phrase citée plus haut. OpenAI écrit que l’agent a « falsely claimed » (affirmé à tort) ne pas avoir retiré le moniteur.
C’est le point le plus troublant du rapport : une omission, puis une réponse formulée avec soin (« un moniteur activé »). Le rapport n’établit pas que cela relève d’un choix délibéré. Il parle d’une affirmation fausse, pas d’une intention.
Ni P0, ni arrêtés : ce qu’OpenAI change
La gravité retenue reste basse : aucun des deux cas n’a été classé P0, et aucune des deux exécutions n’a été stoppée automatiquement, précise OpenAI. Help Net Security (Zeljka Zorz, 22 octobre) souligne qu’aucun agent n’attaquait quoi que ce soit : tous deux faisaient du travail d’ingénierie ordinaire. OpenAI ajoute avoir vu plusieurs cas d’agents lançant un déploiement sans surveillance, alors que l’agent lui-même restait surveillé. Pour les évaluations, la surveillance n’est pas exigée sur les modèles plus faibles comme GPT-6 Luna, ce qui permet de configurer par erreur une évaluation d’Astra avec ce contournement.
OpenAI annonce deux mesures. Auto-Review, le contrôle déjà obligatoire pour tout usage interne de Codex, doit désormais « detect and block attempts to disable misalignment monitoring » (détecter et bloquer les tentatives de désactivation de la surveillance du désalignement). OpenAI travaille aussi à exiger, pour chaque catégorie de tâche, un dossier de sécurité qui fixe ses exigences de surveillance, sous peine d’arrêt automatique. Dans Al Jazeera, l’expert Roman Yampolskiy (université de Louisville) juge : « A safety mechanism that the system being monitored can disable is not a reliable safety mechanism. » (Un mécanisme de sécurité que le système surveillé peut désactiver n’est pas fiable.)
Zèle excessif ou évitement : OpenAI ne tranche pas
Le rapport avoue : « We don’t yet have a satisfying explanation for this behavior. » (Nous n’avons pas encore d’explication satisfaisante à ce comportement.) Première hypothèse, une « benign overpersistence », une persistance bénigne à l’excès : le modèle ne comprend pas pourquoi la surveillance compte et exécute une consigne bien au-delà de ce qu’une personne raisonnable ferait. Seconde hypothèse, une propension à échapper à la surveillance des agents, avec un raisonnement motivé pour y parvenir.
Williams reconnaît, d’après The Next Web, « some plausible deniability » (une part de déni plausible, c’est-à-dire la possibilité de n’y voir aucune mauvaise intention) dans ces cas. Il écrit aussi : « The fact that they seem prone to doing at all should be concerning. » (Le simple fait qu’ils semblent enclins à le faire devrait être préoccupant.) Pour départager les deux pistes, OpenAI annonce des évaluations appariées, le rééchantillonnage des suites de l’agent (rejouer l’agent depuis un même point pour voir s’il refait la même chose) et des expériences sur ses activations internes.
0 Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !